2025 年 2 月 27 日 · JVM 与 Java 锁实践 02

GC 日志里回收得很勤,有人建议把新生代调大;暂停时间偏长,又有人建议把目标压到 50 毫秒。参数看起来都在起作用,但接口 P99 未必变好。

我会先确认:这次停顿是在找根、扫描跨区引用,还是复制了太多存活对象?如果并发标记根本来不及完成,继续压低暂停目标,还可能让系统更忙。

下面固定 JDK 21.0.5 的 G1。重点是把机制、日志和应用对象的生命周期对应起来,再决定是否改参数。

Region 是管理单位,不是固定的一组物理代区

G1 把堆划成等大小的 Region。某些 Region 当前承担 Eden、Survivor 或 Old 的角色,角色可以变化。年轻代不是必须永久占住堆地址空间的前半段。

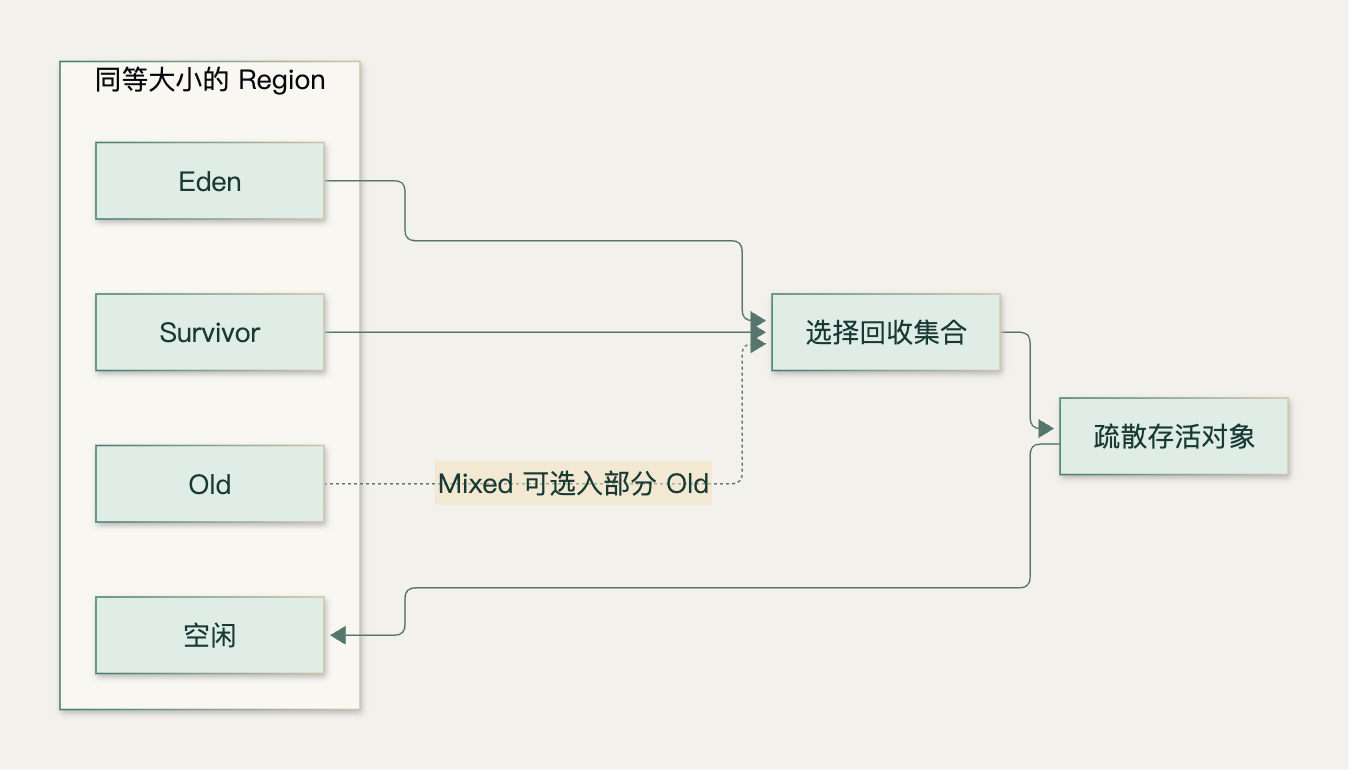
Region、存活集与回收集合的关系

一次暂停会选择 Collection Set,疏散其中仍然存活的对象,然后回收腾空的区域。Young GC 主要围绕年轻代区域;Mixed GC 还会加入一部分选中的老年代区域。Mixed 不等于 Full GC,也不意味着每次把整个老年代扫描回收一遍。 G1 堆的固定版本实现

这使 G1 能按区域组织工作量,但“只回收部分区域”仍然需要知道其他区域有没有引用这里的对象。跨区引用处理是理解暂停成本的一条重要线索。

跨区引用靠屏障和记忆集,不靠每次全堆盲扫

假设一个 Old 区域里的对象,引用了即将回收的年轻代对象。如果只从年轻代内部找引用,这个对象就可能被误判。

G1 会借助 card table、写屏障、记忆集及相关处理路径,记录需要关注的跨区域关系。它们降低了每次回收都遍历整个堆的需求,但也给写入和后台处理增加了成本。指针更新很多、跨区引用密集的对象图,可能让这部分工作明显变重。屏障实现

并发标记还面临另一个问题:应用线程在标记期间修改引用。SATB 的思路是保留标记开始时快照所需的信息;覆盖引用之前,把必要的旧引用记录到相应队列,让并发标记能够正确处理。SATB 队列

这里容易把两件事混起来:为并发标记保留必要的旧引用,与为跨区扫描维护记录,目的并不相同。屏障不是“每次赋值都做一次完整 GC”,记忆集也不是存放所有活对象的另一个堆。

并发阶段之外,仍然有必须一起停下来的工作

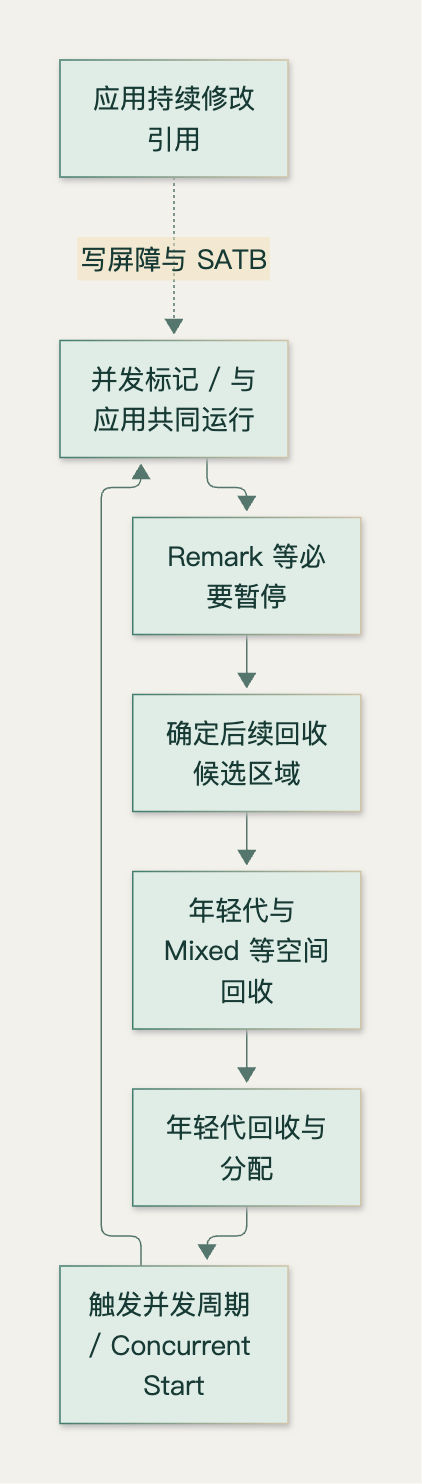
可以沿着下面这张流程图理解一轮典型周期:

并发标记与暂停阶段怎样衔接

并发标记发现哪些区域还有多少活数据,为后续选择回收集合提供依据。Remark 等暂停负责完成必要的全局收尾,之后才进入相应的空间回收过程。具体阶段名称和路径,以日志及该版本实现为准。并发标记实现

因此,“G1 是并发收集器,所以不 STW”这个说法会误导调优。它把部分工作与应用并发执行,同时仍有暂停;并发任务还要和应用争用 CPU 与内存带宽。

如果应用分配快、存活多,并发标记需要更早开始或有更多资源完成;如果回收集合里有很多存活对象,疏散本身就会贵。先分清是哪条路径落后,再调 IHOP、堆大小或暂停目标。

我会先读这四类信息

1
2
3
"$JVM_LAB_JDK/bin/java" -Xms64m -Xmx64m -XX:+UseG1GC \
-Xlog:gc*,safepoint:file=g1.log:uptime,level,tags \
-cp lab/build G1Lab 256

这条命令用于已编译的配套实验。生产上应把日志轮转、磁盘空间和采集量一起配置,别让调试日志无限增长。

先看什么 想确认的问题
暂停类型和原因 普通 Young、Concurrent Start、Mixed 还是 Full
回收前后占用 回收掉的是短命对象,还是存活集持续抬高
阶段分解 根处理、跨区扫描、复制等哪部分最贵
分配与并发周期 新数据增长是否快过回收追赶能力

一行 23M->6M(64M) 表示这次记录中的占用与堆容量变化,不能只看右边剩余很多,就推断配置一定宽松。并发周期期间还要给新分配、晋升和疏散留空间。

延迟也要与接口指标对时:暂停变短,但总暂停次数增加,应用有效工作时间可能下降;GC 日志里没有长暂停,也不能排除线程竞争、调度或外部依赖拖慢请求。

大对象实验:跨过阈值,分配路径就变了

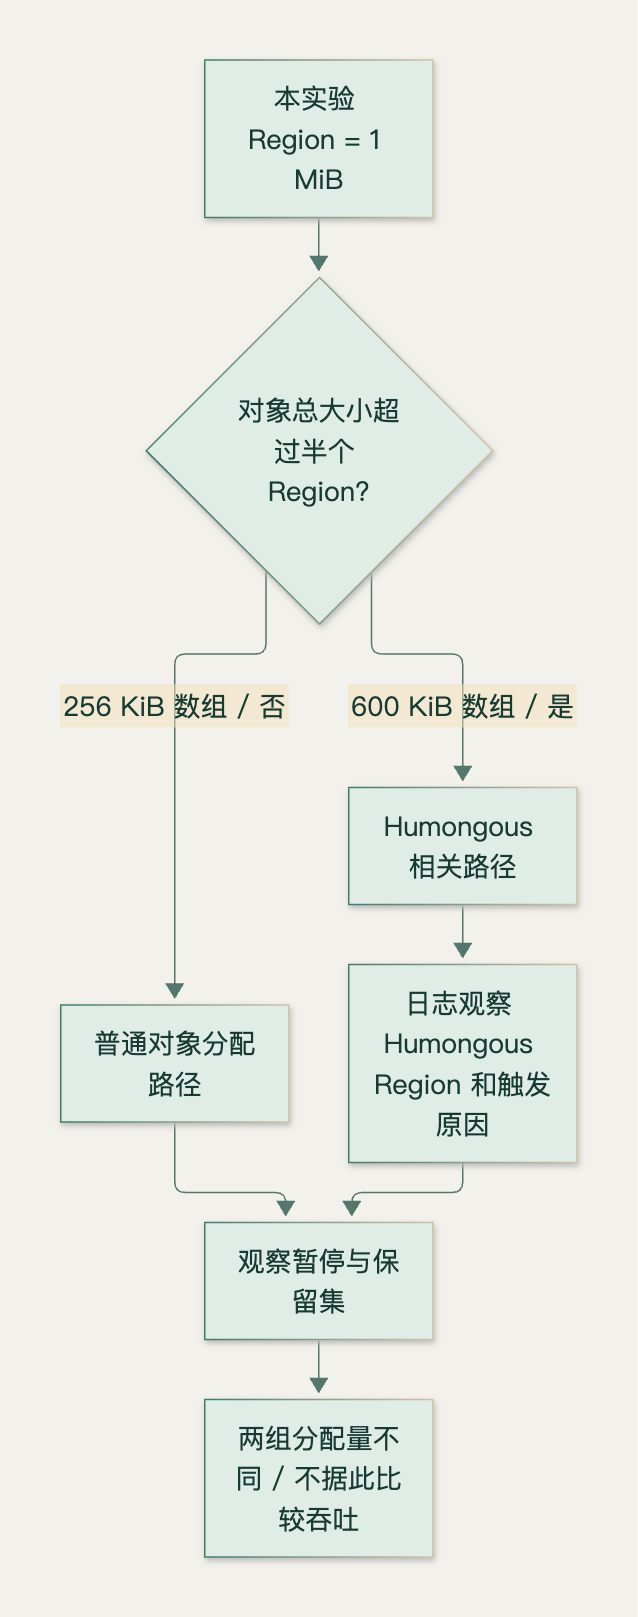
实验把 Region 固定成 1 MiB,分别创建 256 KiB 与 600 KiB 的 byte 数组,循环 2,400 次,始终保留最近 16 个数组。超过半个 Region 的对象会进入 Humongous 相关路径,判断的是对象总大小,数组头也要计算。

两组实际分配字节不同、保留字节也不同,这个实验用于观察路径,不是公平的吞吐对比。

样本 累计分配负载 保留负载 观察到最大 Humongous Region 数 Young 计数
256 KiB 数组 600 MiB 4.000 MiB 0 24
600 KiB 数组 1406 MiB 9.375 MiB 32 235

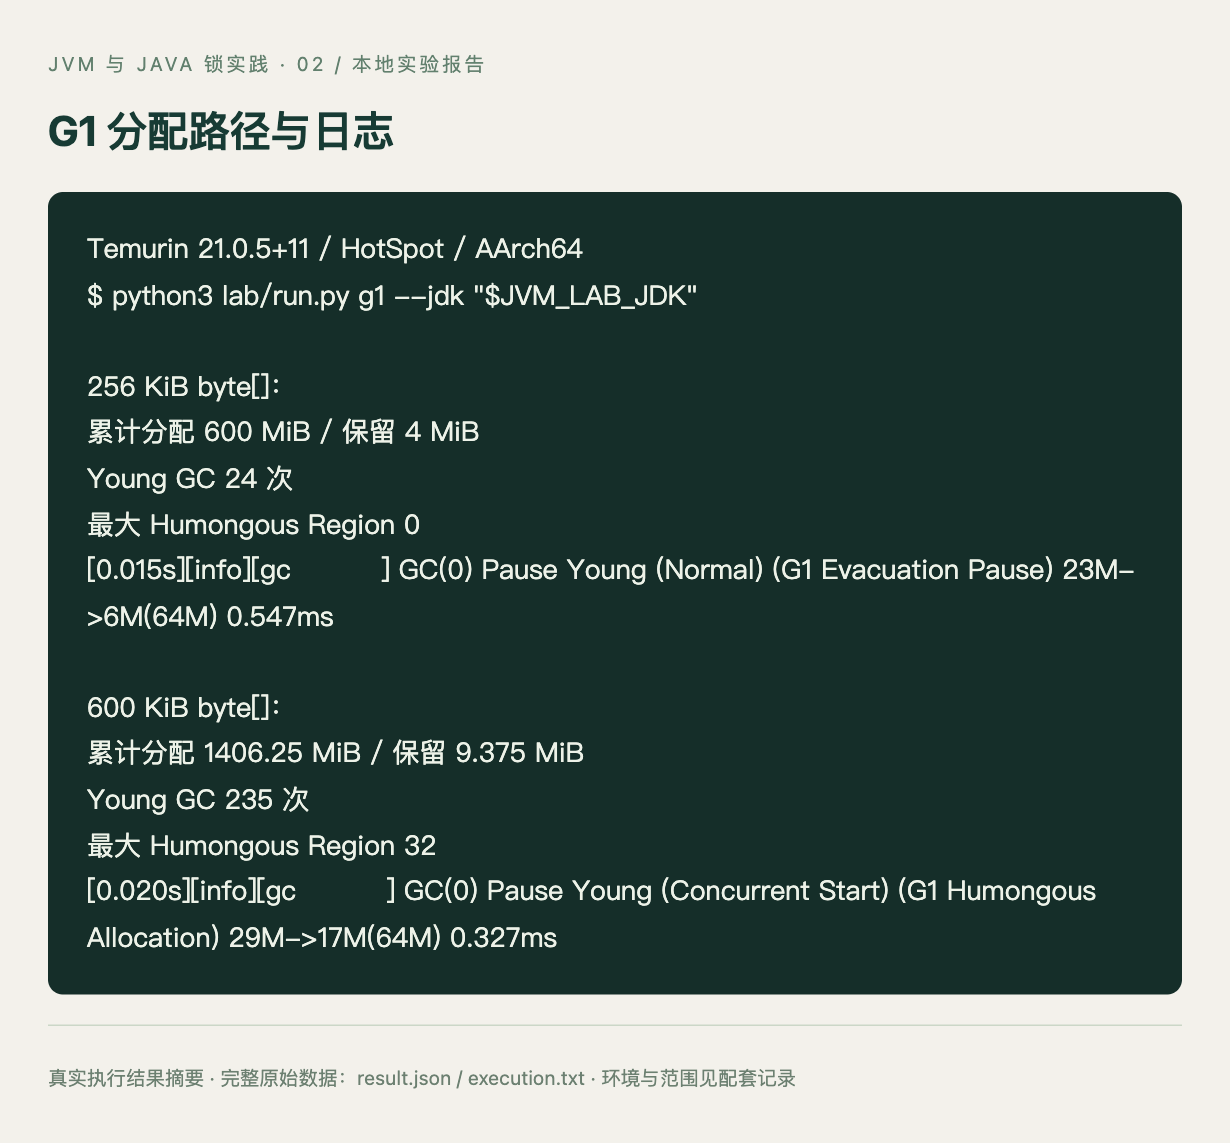
600 KiB 组的日志确实出现了 G1 Humongous Allocation。普通数组组观察到的 Humongous Region 是 0,大数组组则出现了非零值。完整日志保留在配套目录。

普通数组与 Humongous 分配的路径对照

别把 Humongous 当成“必定触发 Full GC”。它可能参与特殊的分配、标记触发与回收路径,实际是否 Full GC 要看日志。这个实验里的 Old Generation 回收计数为 0,也没有因此证明大对象对系统没有代价。

如果业务经常构造大块序列化缓冲,我会先检查能否分块、流式处理、减少复制和调整生命周期。增大 Region 可能改变 Humongous 判定和跨区记录成本,也会改变回收粒度;它需要对照验证,不能只看大对象数下降。

四个参数背后,其实是四种不同的取舍

MaxGCPauseMillis 是目标,不是最大停顿硬保证。G1 根据预测选择工作量,预测会受到存活率和负载变化影响。把目标大幅缩短,可能让年轻代更小、回收更频繁;把它放宽,可能改善吞吐,但要接受更长暂停。

Xmx 决定主要堆空间预算。增大堆能给并发标记和分配更多回旋空间,也会占用更多进程内存,并可能增加某些最坏情况下的工作量。

IHOP 影响并发标记何时启动。G1 有自适应预测逻辑,先确认它是否在业务突增后追不上,再考虑是否需要更保守的起点。不要只看一个百分比就判断“老年代到了这里一定立刻回收”。

Region 大小影响 Humongous 阈值、回收粒度等。调大不是免费避开大对象,而是在换一种成本结构。参数的声明和默认逻辑应回到固定版本源码及实际启动日志检查;G1 专有项还可对照 g1_globals.hpp。

我会避免给 G1 机械套用一套固定新生代尺寸。年轻代规模本来就是它控制暂停工作量的手段之一,强行固定可能限制调节空间。

我怎样做一次能解释结果的对照

先把目标写成业务指标:比如接口 P99、超时率、有效吞吐与容器内存峰值,而不是只写“减少 GC 次数”。然后固定请求分布、对象保留策略、CPU/内存限制和运行时版本,每次只改一组有明确假设的因素。

我会留下预热后的多个时间窗口,同时看 GC 阶段、分配率、存活集和 CPU。需要性能结论时,采用合适的基准与多轮测量;本篇的短程序只验证机制。

1
python3 lab/run.py g1 --jdk "$JVM_LAB_JDK"

源码见 G1Lab.java,结果见原始记录。小堆和显式 Region 配置都是为了让路径容易出现,不是生产模板。

两组 G1 实验的真实日志摘要

G1 调优最后经常会回到应用:大对象能不能少复制一次,缓存能不能少留一轮,批处理能不能缩小峰值。这些改变直接减少了收集器要处理的工作量,也更容易解释收益从哪里来。

本篇完整 Java 示例

下面代码与配套实验使用的源文件一致。编译参数、Agent 打包和 jcmd 采集由 lab/run.py 统一组织,入口见文末实验环境说明。

展开本篇完整 Java 示例
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import java.lang.management.ManagementFactory;

public class G1Lab {
private static volatile long checksum;
public static void main(String[] args) {
int kib = Integer.parseInt(args[0]);
byte[][] retained = new byte[16][];
long allocated = 0;
for (int i = 0; i < 2400; i++) {
byte[] block = new byte[kib * 1024];
block[0] = (byte)i;
retained[i % retained.length] = block;
checksum += block[0];
allocated += block.length;
}
System.out.println("payload_kib=" + kib);
System.out.println("allocated_payload_bytes=" + allocated);
System.out.println("retained_arrays=" + retained.length);
System.out.println("checksum=" + checksum);
ManagementFactory.getGarbageCollectorMXBeans().forEach(gc ->
System.out.println(gc.getName().replace(' ', '_') + "_count=" + gc.getCollectionCount()));
System.out.println("held_payload_bytes=" + (retained.length * (long)kib * 1024));
}
}

实验环境与运行脚本

准备完整的 Temurin 21.0.5+11 JDK,选择与系统架构相符的包,并按同名 .sha256.txt 校验。需要包括 java、javac、jar、jcmd、jfr;这里固定版本是为了对应本文源码与实验结果。

将前面的 Java 示例保存为 lab/G1Lab.java,把下面脚本保存为 lab/run.py。在自己的实验项目根目录执行:

1
2
3
4
export JVM_LAB_JDK=/你的路径/jdk-21.0.5+11
# macOS JDK 包通常需追加 /Contents/Home。
"$JVM_LAB_JDK/bin/java" -version
python3 lab/run.py g1 --jdk "$JVM_LAB_JDK"

Python 脚本无第三方依赖,只编译本篇 Java 示例,输出到本项目的 assets/02-g1/。诊断采集仅针对脚本自己启动的实验 JVM;运行结束会退出该进程。

展开本篇独立运行脚本
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
from pathlib import Path
import argparse,datetime,hashlib,json,os,platform,re,subprocess,time

ROOT=Path(__file__).resolve().parents[1]

def execute(args,timeout=25):
result=subprocess.run([str(x) for x in args],text=True,capture_output=True,timeout=timeout)
if result.returncode:raise RuntimeError(result.stderr[-2500:]+result.stdout[-2000:])
return result.stdout+result.stderr

def pairs(text):
return dict(line.split('=',1) for line in text.splitlines() if re.match(r'^[A-Za-z0-9_]+=',line))

def main():
parser=argparse.ArgumentParser()
parser.add_argument('experiment',choices=['g1','all'])
parser.add_argument('--jdk',required=True)
args=parser.parse_args()
name='g1'
jdk=Path(args.jdk).resolve();java=jdk/'bin/java';javac=jdk/'bin/javac';jar=jdk/'bin/jar';jcmd=jdk/'bin/jcmd'
version=execute([java,'-version'])
assert '21.0.5' in version and '21.0.5+11' in version
build=ROOT/'lab/build';build.mkdir(parents=True,exist_ok=True)
execute([javac,'-d',build,ROOT/'lab/G1Lab.java'])
dest=ROOT/'assets/02-g1';dest.mkdir(parents=True,exist_ok=True);logs=[]
def run(*flags,timeout=25):
command=[java,*flags];out=execute(command,timeout);logs.append('$ '+' '.join(str(x) for x in command)+'\n'+out);return out
result = {}
for size in [256, 600]:
logfile = dest / f'g1-{size}.log'
values = pairs(run('-Xms64m', '-Xmx64m', '-XX:+UseG1GC', '-XX:G1HeapRegionSize=1m', f'-Xlog:gc*,safepoint:file={logfile}:uptime,level,tags', '-cp', build, 'G1Lab', size))
text = logfile.read_text()
counts = [int(x) for x in re.findall('Humongous regions: (\\d+)->', text)]
values['max_humongous_regions_observed'] = max(counts, default=0)
values['pause_lines'] = len(re.findall('Pause.*?ms', text))
values['pause_examples'] = [x for x in text.splitlines() if 'Pause' in x and x.endswith('ms')][:4]
result[str(size)] = values
assert result['256']['max_humongous_regions_observed'] == 0 and result['600']['max_humongous_regions_observed'] > 0
record={'experiment':name,'runtime':version.strip(),'os':platform.platform(),'executed_at':datetime.datetime.now(datetime.timezone.utc).isoformat(),'result':result}
(dest/'result.json').write_text(json.dumps(record,ensure_ascii=False,indent=2))
(dest/'execution.txt').write_text('\n\n'.join(logs))
print(json.dumps({'experiment':name,'result':result},ensure_ascii=False))
if __name__=='__main__':main()

实验记录

下面是本文配图采用的结果摘要;再次运行得到的计数、采样和日志时间会受环境影响。脚本会同时生成完整日志,诊断篇还会生成 JFR 文件。

展开本篇实验结果
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
{
"256": {
"payload_kib": "256",
"allocated_payload_bytes": "629145600",
"retained_arrays": "16",
"checksum": "3408",
"G1_Young_Generation_count": "24",
"G1_Concurrent_GC_count": "0",
"G1_Old_Generation_count": "0",
"held_payload_bytes": "4194304",
"max_humongous_regions_observed": 0,
"pause_lines": 24,
"pause_examples": [
"[0.015s][info][gc ] GC(0) Pause Young (Normal) (G1 Evacuation Pause) 23M->6M(64M) 0.547ms",
"[0.017s][info][gc ] GC(1) Pause Young (Normal) (G1 Evacuation Pause) 41M->8M(64M) 0.492ms",
"[0.017s][info][gc ] GC(2) Pause Young (Normal) (G1 Evacuation Pause) 41M->9M(64M) 0.285ms",
"[0.018s][info][gc ] GC(3) Pause Young (Normal) (G1 Evacuation Pause) 42M->9M(64M) 0.176ms"
]
},
"600": {
"payload_kib": "600",
"allocated_payload_bytes": "1474560000",
"retained_arrays": "16",
"checksum": "3408",
"G1_Young_Generation_count": "235",
"G1_Concurrent_GC_count": "0",
"G1_Old_Generation_count": "0",
"held_payload_bytes": "9830400",
"max_humongous_regions_observed": 32,
"pause_lines": 235,
"pause_examples": [
"[0.020s][info][gc ] GC(0) Pause Young (Concurrent Start) (G1 Humongous Allocation) 29M->17M(64M) 0.327ms",
"[0.021s][info][gc ] GC(2) Pause Young (Concurrent Start) (G1 Humongous Allocation) 28M->17M(64M) 0.157ms",
"[0.021s][info][gc ] GC(4) Pause Young (Concurrent Start) (G1 Humongous Allocation) 28M->17M(64M) 0.137ms",
"[0.021s][info][gc ] GC(6) Pause Young (Concurrent Start) (G1 Humongous Allocation) 28M->17M(64M) 0.110ms"
]
}
}

源码阅读入口

这些链接固定在 21.0.5 对应提交。当前持续更新的文档可能混入后续维护版本说明,本篇的机制判断以这份实现和本次日志为准。