2025 年 3 月 18 日 · JVM 与 Java 锁实践 03

接口不返回,CPU 有时高、有时不高,重启以后恢复。这样的故障最容易留下一个模糊结论:“可能是 JVM 卡了。”

我会先保留能区分问题的证据:时间窗口、请求阶段、线程在做什么、GC 有没有暂停、进程内存是哪一部分增长。只有把这些线索放在一起,才知道重启到底消掉了什么。

这篇用 JDK 21.0.5 的工具,在一个专门创建的进程里同时构造 CPU 热点、Java 级死锁和直接缓冲增长。所有诊断都指向这一个实验 PID,不会扫描或操作机器上其他 Java 服务。

先分症状,再选工具
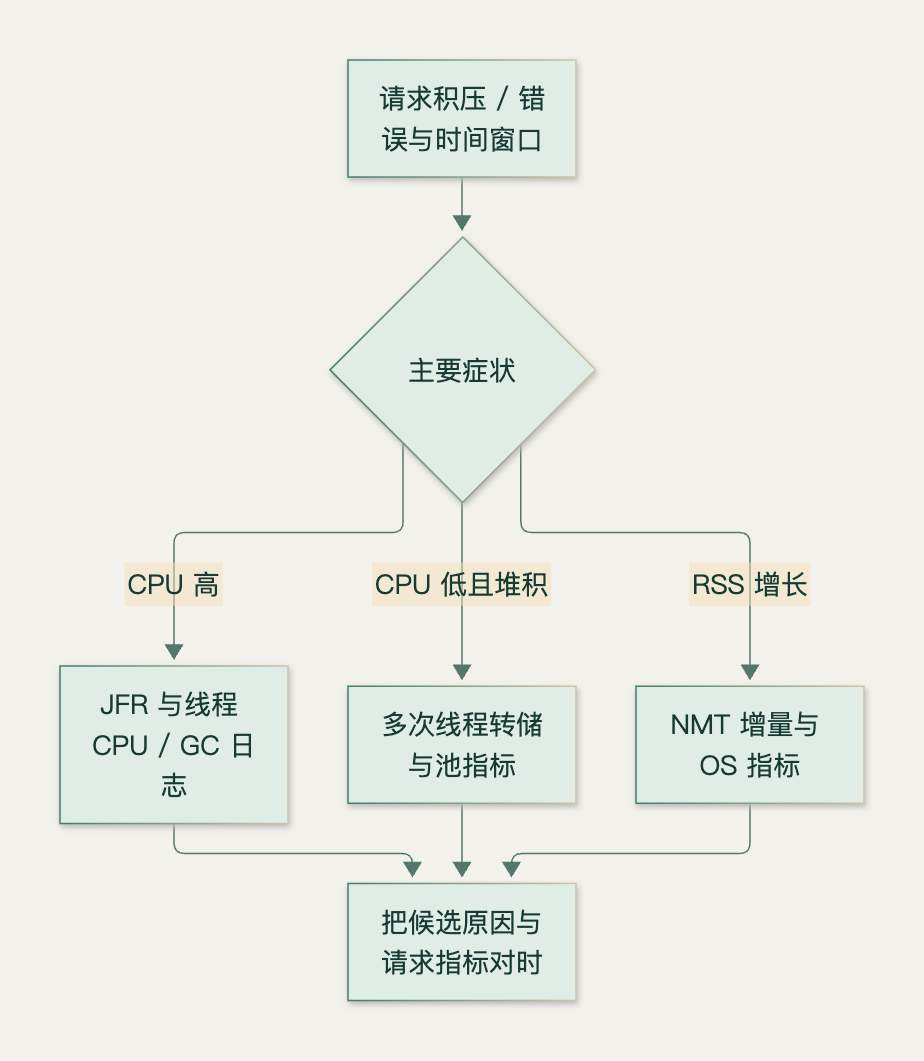
从请求症状选择第一份证据

我会先记录故障开始时间、错误率、P99、实例分布以及最近变更。然后检查应用是不是在等连接池、数据库、网络或队列。外部依赖慢,可能让大量线程合理地等待;它不会因为发生在 Java 进程里,就自动变成 GC 问题。

现象 第一组证据 下一步要区分什么
CPU 高、吞吐低 线程采样、JFR 执行采样、GC 日志 业务计算、重试循环、GC 或锁相关忙等
CPU 低、请求堆积 多次线程转储、池指标 外部等待、锁等待、资源耗尽
RSS 高、堆稳定 NMT 增量、线程数、直接缓冲与 OS 指标 JVM 本地内存、第三方分配、驻留变化
容器直接退出 退出原因、系统与容器事件 OOMKill、应用异常、探针或管理操作

这不是一张“一眼确定根因”的表。它的作用是让下一次采集能排除一种解释,而不是把所有工具同时开到最大。

线程状态有用,但状态名不能替代调用栈

BLOCKED 通常对应进入或重新进入 Java monitor 时的竞争。AQS 一类可显式加锁的等待,常通过 park 表现为 WAITING/TIMED_WAITING。RUNNABLE 也不能简单等同于“此刻正在用满 CPU”,有些本地调用的状态与直觉不同。Thread 状态的固定版本定义

我会连续采集几次线程转储,比较同一批线程的栈是否变化。一次采样只能说明那个瞬间在哪里;反复停在同一段代码,且线程 CPU 时间持续增长,才更支持“这段路径一直在忙”的判断。

1
"$JVM_LAB_JDK/bin/jcmd" <实验PID> Thread.print -l

转储里如果出现一组请求线程都停在池的 acquire,就继续查池容量、占用时间和归还路径。如果都在等同一把锁,就找持有者以及它持锁期间正在等待的资源。
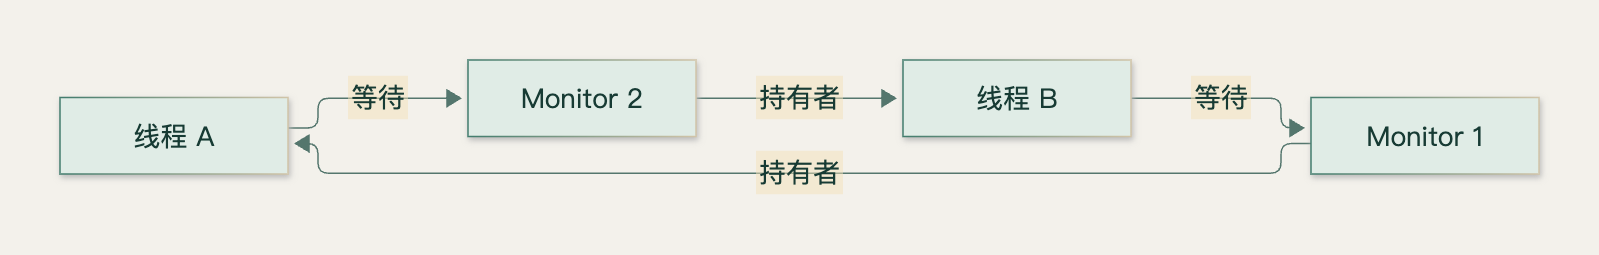
把线程等待关系还原成等待图

线程 A 拿着锁 1 等锁 2,线程 B 拿着锁 2 等锁 1,是可闭合的等待环。可不是所有“线程不动了”都能由 Java 死锁检测器识别:数据库锁、跨进程 RPC、没有关联持有者的业务信号,都需要补上系统外的关系。

把一个确定的死锁,交给工具检查

实验的两条线程用 CountDownLatch 确保分别拿到第一把锁后,再竞争对方那把锁。这样能稳定形成循环等待,避免靠 sleep 猜调度时序。

它们都是 daemon 线程,实验进程还有 40 秒截止;诊断脚本在采集完成后主动退出进程。构造死锁是为了检验工具输出,不把这种代码放进正常业务路径。

本次 Thread.print -l 检出了 Found one Java-level deadlock,同时能看见名为 cpu-worker 的忙线程。两个问题同时存在时,只盯住 CPU 最忙的线程,并不能解释另两个线程为什么永远不能继续。

想修复这个死锁,我会优先统一锁顺序,或减少同时持有多个锁的范围。改成 tryLock 加超时可以为业务提供退出机会,但还得设计失败后的资源回收与重试退避,不能只把永久等待改成无限重试。

JFR 给的是一段时间里的关联线索

JFR 可以在一个时间窗口内记录执行采样、线程停顿、锁相关事件、分配和 GC 等信息。具体事件是否启用、有何阈值,要看所用配置。

1
2
3
4
5
6
"$JVM_LAB_JDK/bin/jcmd" <实验PID> JFR.start name=lab settings=profile
# 在希望观察的时间窗口内执行实验。
"$JVM_LAB_JDK/bin/jcmd" <实验PID> JFR.dump name=lab filename=/tmp/diagnosis.jfr
"$JVM_LAB_JDK/bin/jcmd" <实验PID> JFR.stop name=lab
"$JVM_LAB_JDK/bin/jfr" summary /tmp/diagnosis.jfr
"$JVM_LAB_JDK/bin/jfr" print --events jdk.ExecutionSample /tmp/diagnosis.jfr

这些命令来自本篇实际使用的 JDK。录制配置、持续时间、文件位置和访问权限都应先明确;profile 配置的成本也需要在目标负载验证。

本次录制生成了执行采样事件,文末脚本会在实验目录保存完整 .jfr 和 summary。采样次数不是接口次数,也不能直接当成 CPU 百分比。 我会先定位被反复采中的栈,再结合线程 CPU、吞吐和请求追踪判断意义。

锁等待事件还需要区分:对象 monitor 的竞争,与基于 park 的同步器等待,并非总在同一种事件里出现。阈值以下的等待也可能未被记录,没有事件不能直接证明没有竞争。

NMT 的增量,适合检验“哪一类在长”

实验进程启动时加了 -XX:NativeMemoryTracking=summary。先分配并持有 8 MiB 的直接 ByteBuffer,打 baseline,再额外分配 4 MiB,最后看增量:

1
2
3
"$JVM_LAB_JDK/bin/jcmd" <实验PID> VM.native_memory baseline
# 向本实验进程发送 grow,增加并保留 4 MiB 直接缓冲。
"$JVM_LAB_JDK/bin/jcmd" <实验PID> VM.native_memory summary.diff scale=KB

本次实际输出摘录:

1
2
-                     Other (reserved=12322KB +4130KB, committed=12322KB +4130KB)
jdk.ExecutionSample 110 1100

这里的 Other 也可能包含其他本地分配,所以实际增量没有义务精确等于 4,096 KiB。我们知道本实验主动改变了什么,再用增量核验相关类别,这比看见 Other 很大就断言“肯定是 DirectByteBuffer 泄漏”严谨得多。直接缓冲相关实现

NMT 主要跟踪 HotSpot 的内部内存活动,对部分第三方本地库并不全面;reserved、committed 与 RSS 也不是一组可以直接互换的数。若 NMT 稳定而 RSS 持续上升,仍需结合映射、分配器和 OS 信息继续查。

有些采集会改变现场,顺序要想清楚

堆转储和类直方图可能带来明显停顿或 GC,文件也可能很大。它们很有用,但我会先确认故障窗口和空间预算,再决定是否采集,以及是否允许只保留存活对象的代价。

本次演示使用线程转储、NMT 和 JFR,没有生成堆转储。真实排查若怀疑堆中对象保留,我会继续看直方图和引用链,最终找到把对象留住的 GC Root;“某类实例很多”只是入口,不是泄漏的完整解释。
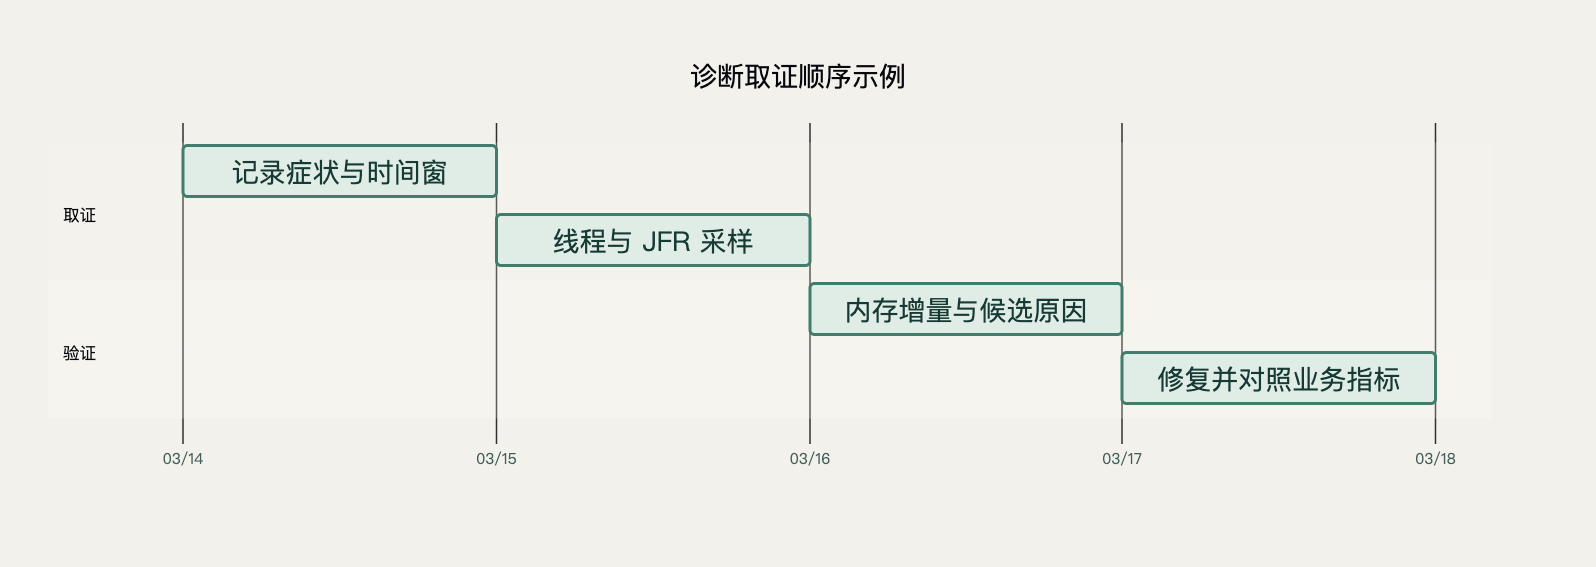
现场保留、定位、修复和验证的顺序

采集出来的线程参数、堆内容和录制信息可能包含业务数据。存放、传输和保留时间应按团队现有规则处理;不要把整份生产转储直接贴到公共帖子里。

用一套能自动结束的实验练习

1
python3 lab/run.py diagnosis --jdk "$JVM_LAB_JDK"

DiagnosisLab.java只负责构造现场,run.py负责目标 PID、采集和清理。线程转储、NMT diff、JFR 与结果摘要保存在同一个实验目录。
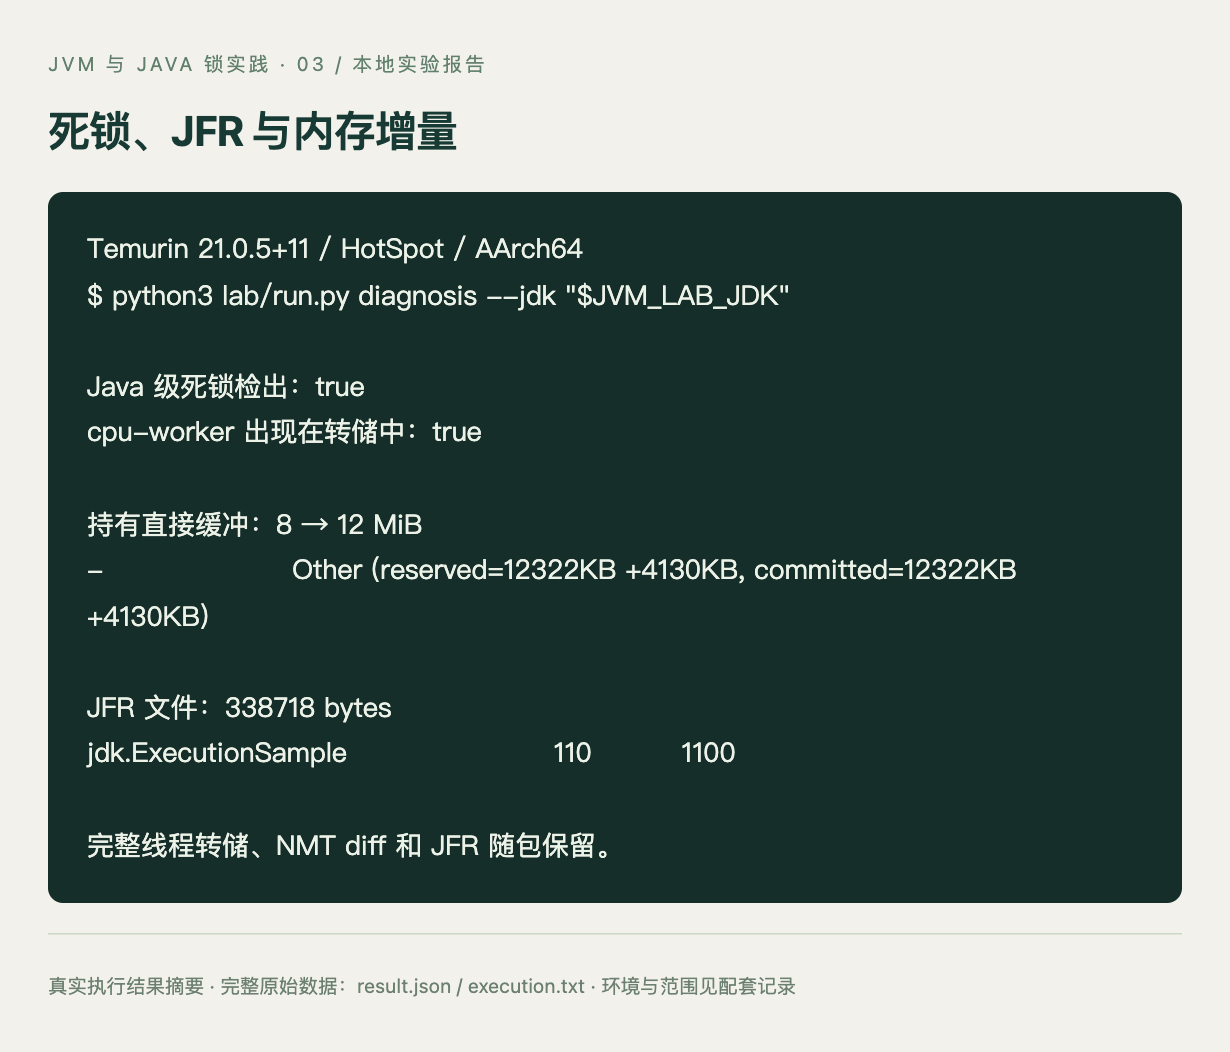
死锁、JFR 采样和 NMT 增量的真实记录

我会把最终结论写成“什么证据支持哪个原因,修复后哪项指标改变了”。如果只有一次重启成功,就把它记录为恢复动作,继续保留对根因的不确定性。这样下一次同类故障出现时,团队能接着已有证据往前走。

本篇完整 Java 示例

下面代码与配套实验使用的源文件一致。编译参数、Agent 打包和 jcmd 采集由 lab/run.py 统一组织,入口见文末实验环境说明。

展开本篇完整 Java 示例
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.nio.ByteBuffer;
import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;

public class DiagnosisLab {
static final List<ByteBuffer> retained = new ArrayList<>();
static final Object first = new Object(), second = new Object();
static volatile long checksum;
static void deadlock(String name, Object a, Object b, CountDownLatch both) {
Thread thread = new Thread(() -> {
synchronized (a) {
both.countDown();
try { both.await(); } catch (InterruptedException error) { return; }
synchronized (b) { checksum++; }
}
}, name);
thread.setDaemon(true); thread.start();
}
public static void main(String[] args) throws Exception {
// 只在本实验进程内构造死锁;线程都是 daemon,进程有 40 秒硬截止。
Thread watchdog = new Thread(() -> {
try { TimeUnit.SECONDS.sleep(40); } catch (InterruptedException ignored) {}
System.exit(0);
}, "lab-deadline");
watchdog.setDaemon(true); watchdog.start();
retained.add(ByteBuffer.allocateDirect(8 * 1024 * 1024));
CountDownLatch both = new CountDownLatch(2);
deadlock("deadlock-A", first, second, both);
deadlock("deadlock-B", second, first, both);
Thread cpu = new Thread(() -> { while (!Thread.currentThread().isInterrupted()) checksum++; }, "cpu-worker");
cpu.setDaemon(true); cpu.start();
System.out.println("READY pid=" + ProcessHandle.current().pid()); System.out.flush();
BufferedReader input = new BufferedReader(new InputStreamReader(System.in));
for (String line; (line = input.readLine()) != null;) {
if (line.equals("grow")) {
retained.add(ByteBuffer.allocateDirect(4 * 1024 * 1024));
System.out.println("GROWN direct_buffers=12MiB"); System.out.flush();
} else if (line.equals("quit")) break;
}
cpu.interrupt();
}
}

实验环境与运行脚本

准备完整的 Temurin 21.0.5+11 JDK,选择与系统架构相符的包,并按同名 .sha256.txt 校验。需要包括 java、javac、jar、jcmd、jfr;这里固定版本是为了对应本文源码与实验结果。

将前面的 Java 示例保存为 lab/DiagnosisLab.java,把下面脚本保存为 lab/run.py。在自己的实验项目根目录执行:

1
2
3
4
export JVM_LAB_JDK=/你的路径/jdk-21.0.5+11
# macOS JDK 包通常需追加 /Contents/Home。
"$JVM_LAB_JDK/bin/java" -version
python3 lab/run.py diagnosis --jdk "$JVM_LAB_JDK"

Python 脚本无第三方依赖,只编译本篇 Java 示例,输出到本项目的 assets/03-diagnosis/。诊断采集仅针对脚本自己启动的实验 JVM;运行结束会退出该进程。

展开本篇独立运行脚本
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
from pathlib import Path
import argparse,datetime,hashlib,json,os,platform,re,subprocess,time

ROOT=Path(__file__).resolve().parents[1]

def execute(args,timeout=25):
result=subprocess.run([str(x) for x in args],text=True,capture_output=True,timeout=timeout)
if result.returncode:raise RuntimeError(result.stderr[-2500:]+result.stdout[-2000:])
return result.stdout+result.stderr

def pairs(text):
return dict(line.split('=',1) for line in text.splitlines() if re.match(r'^[A-Za-z0-9_]+=',line))

def main():
parser=argparse.ArgumentParser()
parser.add_argument('experiment',choices=['diagnosis','all'])
parser.add_argument('--jdk',required=True)
args=parser.parse_args()
name='diagnosis'
jdk=Path(args.jdk).resolve();java=jdk/'bin/java';javac=jdk/'bin/javac';jar=jdk/'bin/jar';jcmd=jdk/'bin/jcmd'
version=execute([java,'-version'])
assert '21.0.5' in version and '21.0.5+11' in version
build=ROOT/'lab/build';build.mkdir(parents=True,exist_ok=True)
execute([javac,'-d',build,ROOT/'lab/DiagnosisLab.java'])
dest=ROOT/'assets/03-diagnosis';dest.mkdir(parents=True,exist_ok=True);logs=[]
def run(*flags,timeout=25):
command=[java,*flags];out=execute(command,timeout);logs.append('$ '+' '.join(str(x) for x in command)+'\n'+out);return out
process = subprocess.Popen([str(java), '-Xms64m', '-Xmx64m', '-XX:NativeMemoryTracking=summary', '-cp', str(build), 'DiagnosisLab'], stdin=subprocess.PIPE, stdout=subprocess.PIPE, stderr=subprocess.STDOUT, text=True)
try:
first = process.stdout.readline()
assert first.startswith('READY pid='), first
pid = str(process.pid)
logs.append(first)

def inspect(command, label):
out = execute([jcmd, pid, *command], 20)
(dest / label).write_text(out)
logs.append('$ jcmd <实验PID> ' + ' '.join(command) + '\n' + out)
return out
baseline = inspect(['VM.native_memory', 'baseline'], 'nmt-baseline.txt')
inspect(['JFR.start', 'name=lab', 'settings=profile'], 'jfr-start.txt')
stacks = inspect(['Thread.print', '-l'], 'threads.txt')
assert 'Found one Java-level deadlock' in stacks and 'cpu-worker' in stacks
process.stdin.write('grow\n')
process.stdin.flush()
grown = process.stdout.readline()
assert grown.startswith('GROWN')
delta = inspect(['VM.native_memory', 'summary.diff', 'scale=KB'], 'nmt-diff.txt')
time.sleep(1)
inspect(['JFR.dump', 'name=lab', 'filename=' + str((dest / 'diagnosis.jfr').resolve())], 'jfr-dump.txt')
inspect(['JFR.stop', 'name=lab'], 'jfr-stop.txt')
summary = execute([jdk / 'bin/jfr', 'summary', dest / 'diagnosis.jfr'])
(dest / 'jfr-summary.txt').write_text(summary)
result = {'java_level_deadlock_found': True, 'cpu_worker_present': True, 'direct_buffers_before_mib': 8, 'direct_buffers_after_mib': 12, 'nmt_other_delta_line': next((x.strip() for x in delta.splitlines() if '- Other' in x or re.search('-\\s+Other \\(', x))), 'jfr_bytes': (dest / 'diagnosis.jfr').stat().st_size, 'jfr_execution_samples_line': next((x.strip() for x in summary.splitlines() if 'jdk.ExecutionSample ' in x), 'no samples')}
finally:
if process.poll() is None:
try:
process.stdin.write('quit\n')
process.stdin.flush()
process.communicate(timeout=5)
except (BrokenPipeError, subprocess.TimeoutExpired):
process.kill()
process.communicate()
record={'experiment':name,'runtime':version.strip(),'os':platform.platform(),'executed_at':datetime.datetime.now(datetime.timezone.utc).isoformat(),'result':result}
(dest/'result.json').write_text(json.dumps(record,ensure_ascii=False,indent=2))
(dest/'execution.txt').write_text('\n\n'.join(logs))
print(json.dumps({'experiment':name,'result':result},ensure_ascii=False))

if __name__=='__main__':main()

实验记录

下面是本文配图采用的结果摘要;再次运行得到的计数、采样和日志时间会受环境影响。脚本会同时生成完整日志,诊断篇还会生成 JFR 文件。

展开本篇实验结果
1
2
3
4
5
6
7
8
9
{
"java_level_deadlock_found": true,
"cpu_worker_present": true,
"direct_buffers_before_mib": 8,
"direct_buffers_after_mib": 12,
"nmt_other_delta_line": "- Other (reserved=12322KB +4130KB, committed=12322KB +4130KB)",
"jfr_bytes": 338718,
"jfr_execution_samples_line": "jdk.ExecutionSample 110 1100"
}

阅读入口