2025 年 2 月 12 日 · JVM 与 Java 锁实践 01
容器给了 2 GiB,Java 堆只设 1.5 GiB,进程还是被杀了。排查时看一眼堆曲线,发现还有空间,于是开始怀疑监控不准。
我会先换一个问题:容器限制的是谁的内存?-Xmx 限的是 Java 堆,不是整个 Java 进程。线程栈、类元数据、直接缓冲、JIT 代码、GC 自己的数据结构,都还要找地方放。
这篇从一个对象的大小讲起,最后走到进程预算。实验固定 Temurin 21.0.5+11、64 位 HotSpot,源码固定到对应 OpenJDK 提交。这样讨论对象头和指针宽度时,至少知道自己在说哪个实现。
规范里的运行时区域,不等于监控图上的几条线
JVMS 定义了堆、方法区、线程私有栈、程序计数器等运行时区域,但不要求所有虚拟机用同样的物理布局。HotSpot 的 Metaspace 是具体实现,不能直接拿“方法区”这个规范概念与某块固定内存画等号。JVMS 21 的运行时数据区
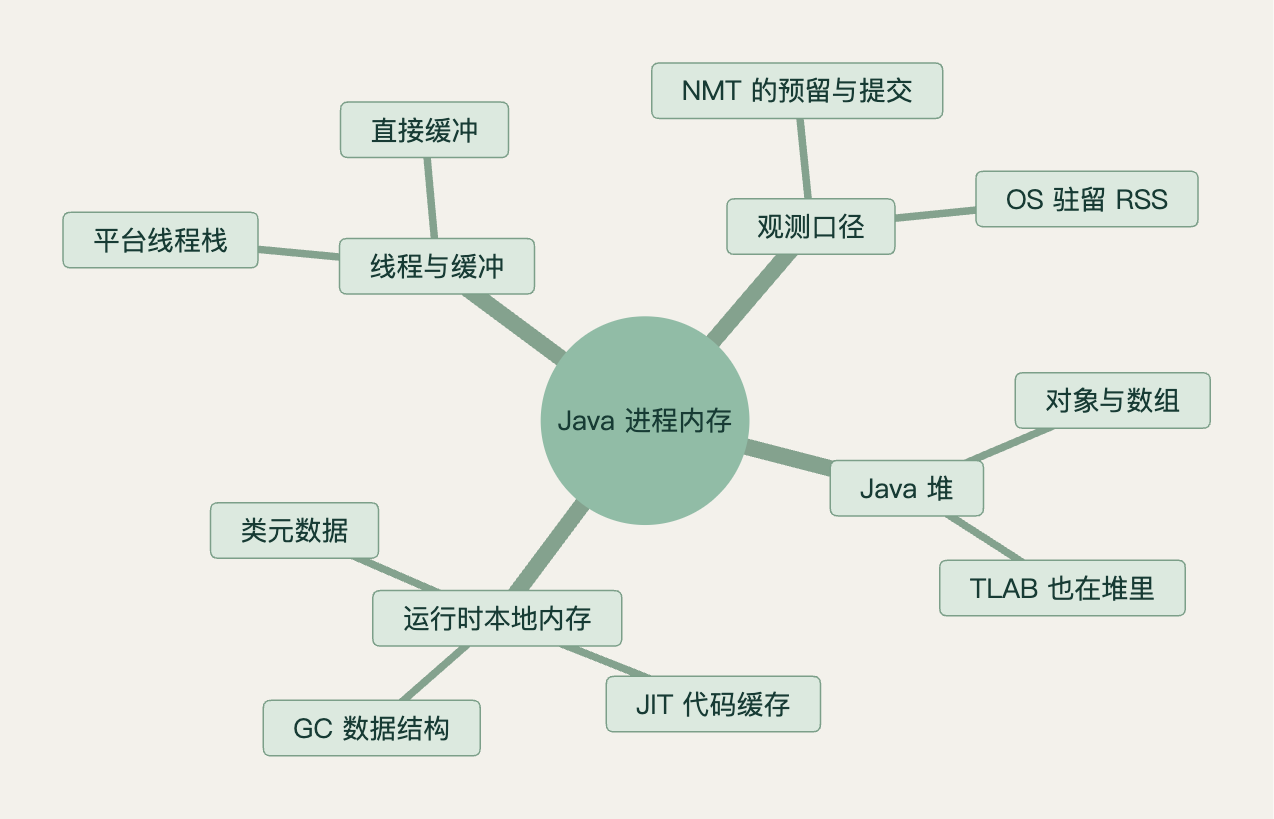
我会把几个常见口径分开:
| 口径 | 它回答的问题 | 容易误解的地方 |
|---|---|---|
| Heap used | 当前已使用的 Java 堆有多少 | 不是进程总占用 |
| Heap committed | JVM 已提交多少堆空间 | 不等于每页都已驻留 |
| Heap max | Java 堆可增长到哪里 | 不是 RSS 上限 |
| NMT reserved / committed | HotSpot 跟踪到哪些本地内存承诺 | 不覆盖所有第三方本地分配,也不是 RSS |
| RSS | 当前驻留在物理内存的页面有多少 | 共享页面、分配器和 OS 行为会影响解释 |
把这些数直接相加也会重复计算。预算按用途分组,验证时则要让 JVM 指标、操作系统指标和容器计费口径彼此对上。
一个对象装的,远不止几个业务字段
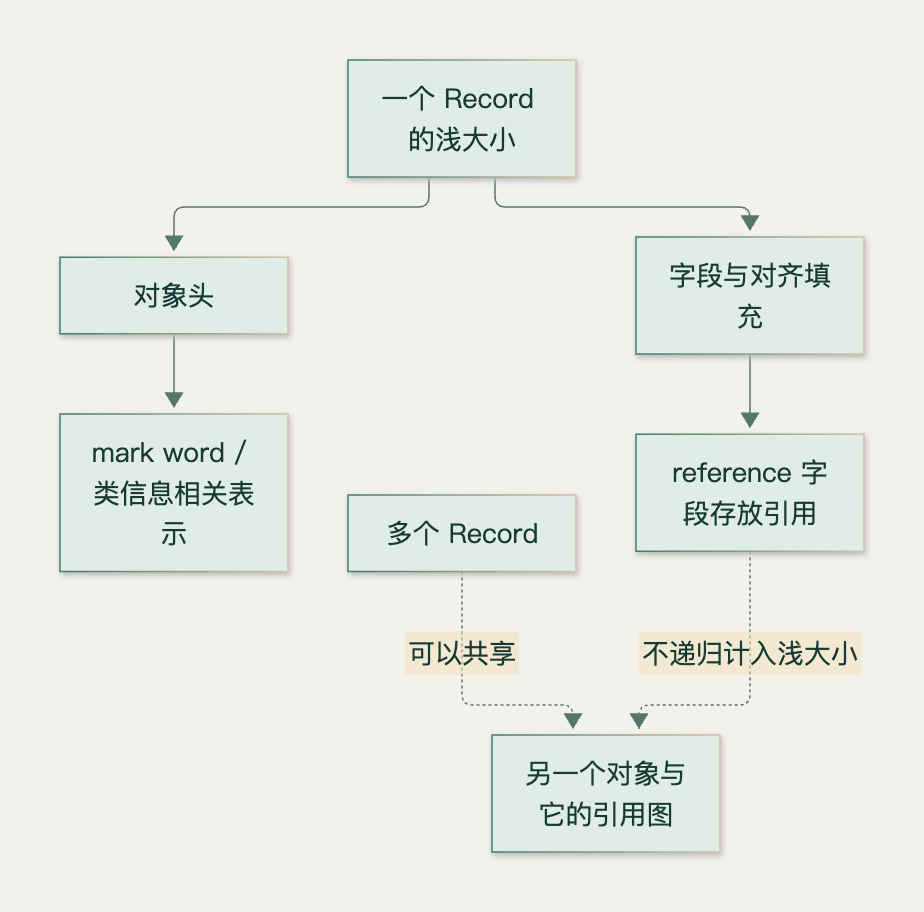
对象一般需要对象头、字段和对齐填充。数组还要记录长度。对象引用指向对象,不代表引用本身包含了整个对象。
本文这套 HotSpot 的 mark word 承担锁状态、哈希等相关信息;类型信息则与类指针有关。具体位布局可以从 markWord.hpp读起。这里不要把一种运行参数下的对象头大小写成 Java 语言永久规定。
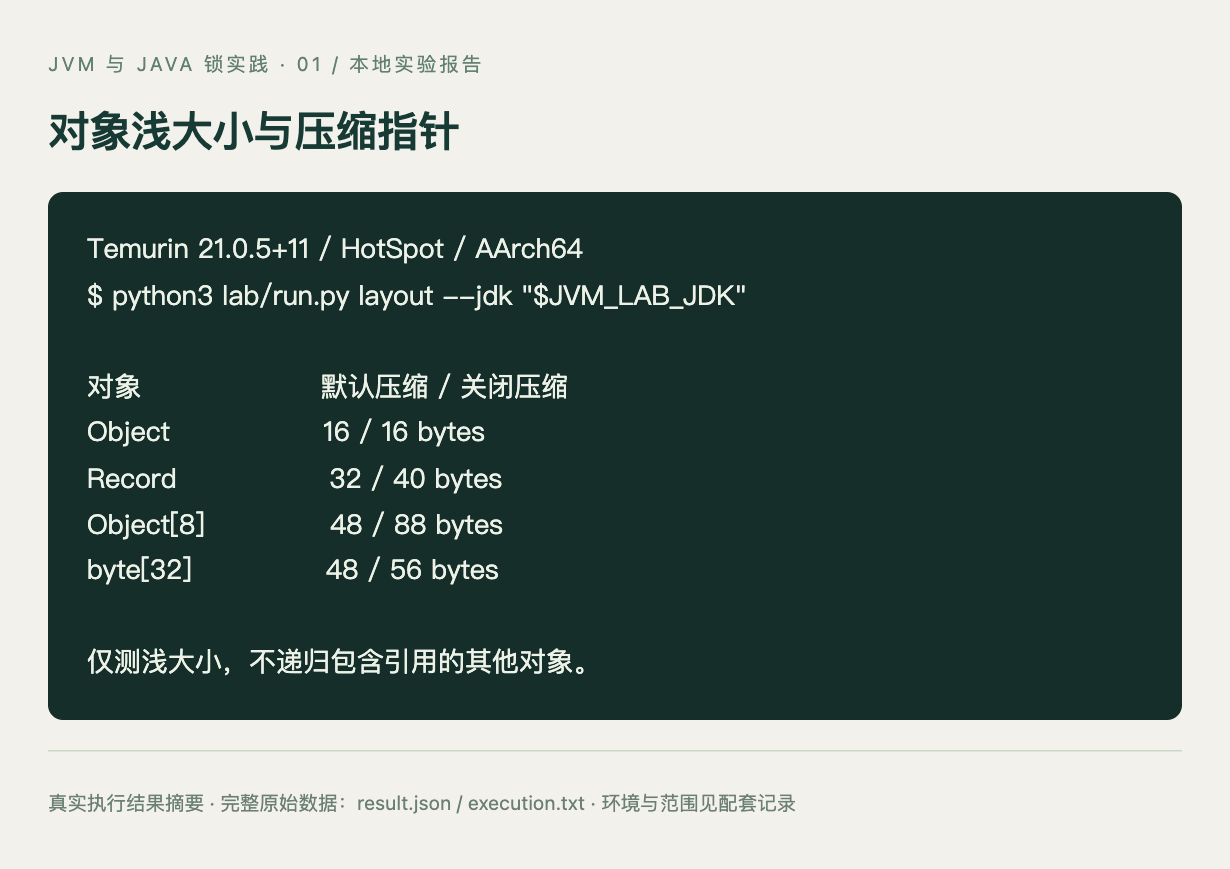
我用 Instrumentation.getObjectSize 测了四种对象,并对比默认压缩指针与关闭两种压缩选项的结果:
| 对象 | 默认压缩配置 | 关闭两种压缩 |
|---|---|---|
| 空对象 | 16 字节 | 16 字节 |
| 三个字段的 Record | 32 字节 | 40 字节 |
| Object[8] | 48 字节 | 88 字节 |
| byte[32] | 48 字节 | 56 字节 |
实验对象 Record 只有 int flags、long sequence、Object reference 三个字段。32 字节不是字段名长度,也不是把源码声明顺序简单相加;对齐和 HotSpot 的字段布局都在参与结果。
Object[8] 默认是 48 字节,关闭压缩后是 88 字节,说明大量引用本身也有可观成本。如果一个图里有几千万条边,只计算最终字符串内容,容量估算会差得很远。
这里测的是浅大小:Record 引用的那个对象,不会递归算进去。两个对象共享同一个大数组,也不能在深大小统计时无条件各算一遍。排查保留内存时,还需要对象图、支配关系和 GC Roots,而不是只看单个对象有多大。
压缩指针为什么省空间,又为什么不能只看 Xmx
压缩对象指针可以理解为一种带基址与缩放规则的编码,把较短的引用表示映射回实际地址。类指针是否压缩是另一个配置,两者不要混在一起。
对象对齐、堆大小、地址布局等会影响实际启用情况。因此我会先检查真实进程:
1 | "$JVM_LAB_JDK/bin/java" -XX:+PrintFlagsFinal -version |
本实验显式关闭 UseCompressedOops 和 UseCompressedClassPointers,只是为了形成清楚的对照,不是在建议给生产加这两个关闭参数。
把堆放大,有时会改变对象引用的表示和对象密度;更大的堆还可能让一次全堆操作的工作量增加。容量调整需要观察对象数、存活集和回收行为,不能只期待“多给一倍内存,一定多撑一倍流量”。
TLAB 在堆里,逃逸分析也不是一张栈分配许可证
TLAB 是给线程使用的堆内分配区域。线程在自己的区域内快速推进分配指针,可以减少频繁争用公共分配路径。它是堆的一部分,不是在每个线程栈里另开一个“小对象堆”。TLAB 分配入口
TLAB 不够用时,可能申请新的区域,也可能走别的分配路径。大对象、初始化、GC 和线程状态都会影响实际路径。看到了快分配路径,也不能推导出“创建对象没有成本”。
逃逸分析解决的又是另一个问题:优化器若证明对象不需要以完整形态对外可见,可以做标量替换、消除部分分配或同步。源码里写了 new,不代表最终每次都分配;对象没逃逸,也不代表所有 HotSpot 版本都承诺把它整体放到栈上。
可以从固定版本的逃逸分析实现继续核对优化条件。我会用真实分配率或合适的基准工具验证优化,不用一个空循环的耗时证明“Java 对象创建极快”。基准要防止死代码消除、常量折叠,并考虑预热、编译层级和不同 fork。
堆外增长,先找生命周期,别先改一个更大的上限
直接 ByteBuffer 的 Java 包装对象在堆上,承载内容的内存可以在堆外。包装对象失去可达性,到关联资源完成回收,并不是业务逻辑上的同一瞬间。连接池、缓冲池和本地库若仍持有引用,堆曲线可能很平,RSS 却继续增长。
Bits.reserveMemory 的容量统计与限制检查,是理解直接缓冲分配路径的一个入口。Bits.java不能解释所有 JNI、本地库或内存映射的占用,也不要把 MaxDirectMemorySize 当作“所有堆外内存”的总开关。
线程数同样值得量化:线程栈预算大致随平台线程数量增长,但预留空间、已提交页面与实际驻留不完全一样。元空间取决于类及类加载器生命周期,Code Cache 又由 JIT 使用。把这几类增长全部叫成“堆泄漏”,会让排查方向偏掉。
容器预算,我会留给故障时最需要的那部分空间
假设限制 2 GiB,我会先列 Java 堆、线程栈、本地缓冲、元空间、代码缓存和 GC/运行时余量,再用压测确认峰值。这是一张预算表,不是一套固定比例公式。
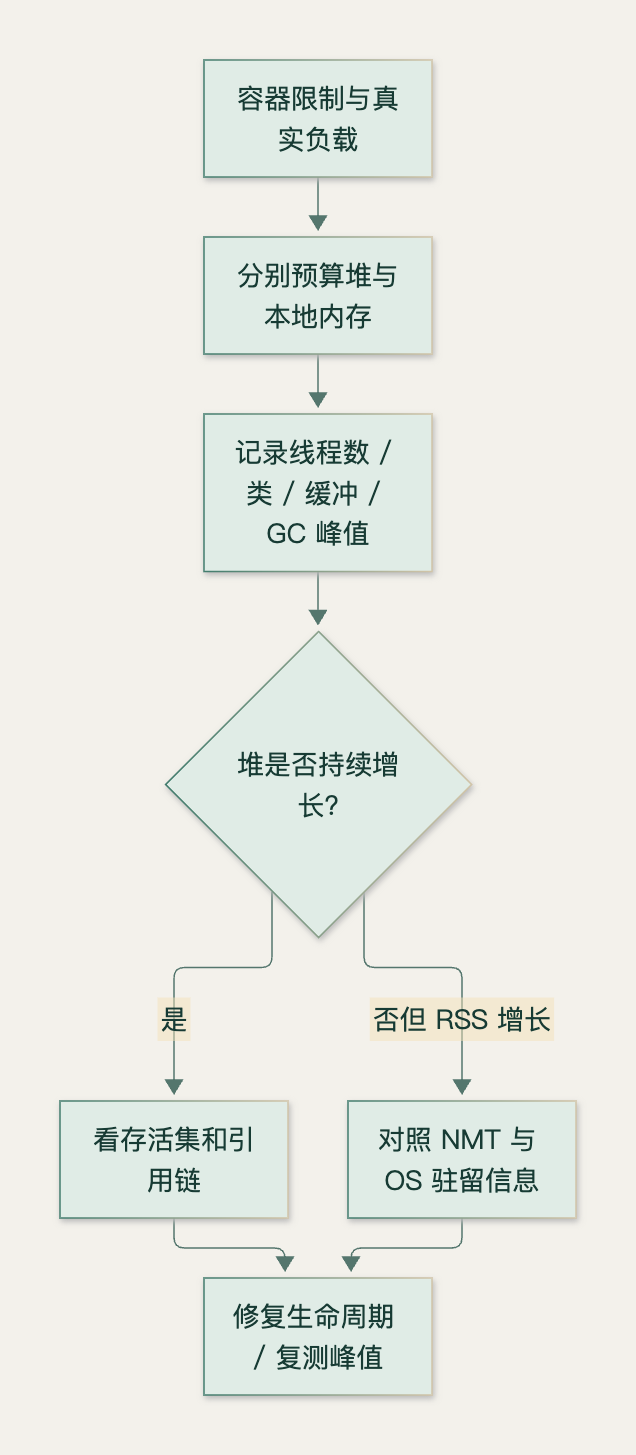
堆使用量稳定而 RSS 上升时,先对比线程数、类加载、直接缓冲和 NMT 增量;堆在 Full GC 后仍持续抬升,再看存活对象与引用链。容器被 OOMKill 时,则要把退出原因与系统记录补齐,它不一定产生 Java 层的 OutOfMemoryError 或堆转储。
NMT 需要在 JVM 启动时启用,例如 -XX:NativeMemoryTracking=summary。用 baseline 与 summary.diff 看变化,会比只看一张总量截图更有价值。NMT 自己有成本,并且不等于操作系统的全量内存归因;后续诊断实验会把这些证据串起来。
动手测,不背一张固定字节数表
从自己的实验项目根目录执行,JVM_LAB_JDK 指向文末说明中的 JDK 21.0.5:
1 | python3 lab/run.py layout --jdk "$JVM_LAB_JDK" |
脚本编译一个最小 Java Agent,在 premain 接收 Instrumentation,再测浅大小。Java 源码是 LayoutLab.java,运行组织见 run.py,完整结果见实验记录。不用依赖外部对象布局工具。
我希望容量方案最后能回答两件事:单位业务数据究竟要留住多少对象,以及流量上来后,进程的哪部分内存会继续增长。对象布局解释单个对象的成本,生命周期才决定它们会不会一直留着。
本篇完整 Java 示例
下面代码与配套实验使用的源文件一致。编译参数、Agent 打包和 jcmd 采集由 lab/run.py 统一组织,入口见文末实验环境说明。
展开本篇完整 Java 示例
1 | import java.lang.instrument.Instrumentation; |
实验环境与运行脚本
准备完整的 Temurin 21.0.5+11 JDK,选择与系统架构相符的包,并按同名 .sha256.txt 校验。需要包括 java、javac、jar、jcmd、jfr;这里固定版本是为了对应本文源码与实验结果。
将前面的 Java 示例保存为 lab/LayoutLab.java,把下面脚本保存为 lab/run.py。在自己的实验项目根目录执行:
1 | export JVM_LAB_JDK=/你的路径/jdk-21.0.5+11 |
Python 脚本无第三方依赖,只编译本篇 Java 示例,输出到本项目的 assets/01-memory/。诊断采集仅针对脚本自己启动的实验 JVM;运行结束会退出该进程。
展开本篇独立运行脚本
1 | from pathlib import Path |
实验记录
下面是本文配图采用的结果摘要;再次运行得到的计数、采样和日志时间会受环境影响。脚本会同时生成完整日志,诊断篇还会生成 JFR 文件。
展开本篇实验结果
1 | { |
资料入口
- JVMS 21 运行时数据区:先区分规范与 HotSpot 实现。
- 固定提交的 markWord.hpp、Metaspace 实现、Bits.java:分别核对对象头、类元数据和直接缓冲相关路径。
- Temurin 21.0.5+11 官方发布:本系列实际运行版本。