2026 年 2 月 6 日
以前等 AI 写代码,最常见的动作是看着光标继续往下跳。现在生成速度越来越快,新的麻烦开始出现:这个任务还没审完,下一个任务的改动已经堆上来了。
2 月 2 日发布的 Codex app,把并行任务、项目列表和改动审查放到桌面工作流里,也提供了 worktree 支持。发布记录 我更在意的不是能开多少个任务,而是这些任务怎样保持各自清楚,最后还能放回一个可运行的项目。
GitHub 上的 Codex 开源仓库也在持续更新。2 月 6 日的提交里,既有异步相关改动,也有依赖安全修复。同期仓库 从这些小改动看,Agent 产品要处理的不只是一段模型输出,还包括执行、运行环境和大量工程细节。
宝玉在 2 月初解读 Claude Code 团队技巧时,也谈到了多目录并行,同时提醒复杂任务并发会占用人的注意力。相关观点 这个提醒放在 Codex 上同样成立:把编辑工作分开以后,审查和集成的工作并没有自动消失。
所以,动手开第二个 Agent 之前,我会先做一个小实验:让两个工作目录各自完成改动,再看看它们合到一起时会发生什么。
worktree 隔开的是什么
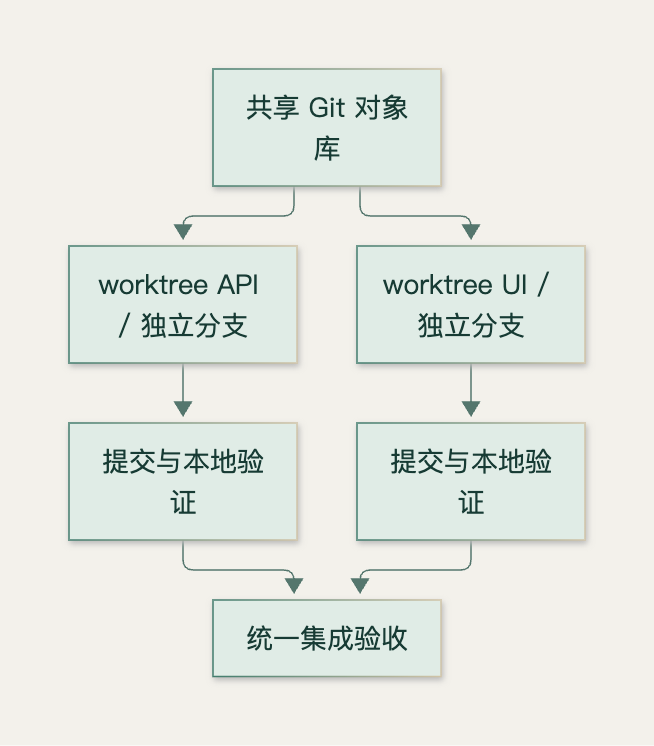
一个 Git 仓库可以拥有多个工作目录,每个目录检出自己的分支。对象库仍共享,但未提交文件分别位于不同目录。
这适合多个任务同时修改不同功能。它不自动隔离数据库、监听端口、用户级配置和外部服务。两个目录如果都连到同一个开发数据库,照样可能互相影响。
跑一个真的隔离实验
本例创建临时仓库和两个 worktree,各自提交对同一字段的不同修改。主目录先保持原样;随后实际尝试合并,确认公共字段会出现冲突,再中止这次合并。临时仓库在退出时自动清理。
在系列目录下运行,需 Python 3.10+;本篇的 Git 实验另需 Git:
1 | python3 examples/lab_v2.py 03 |
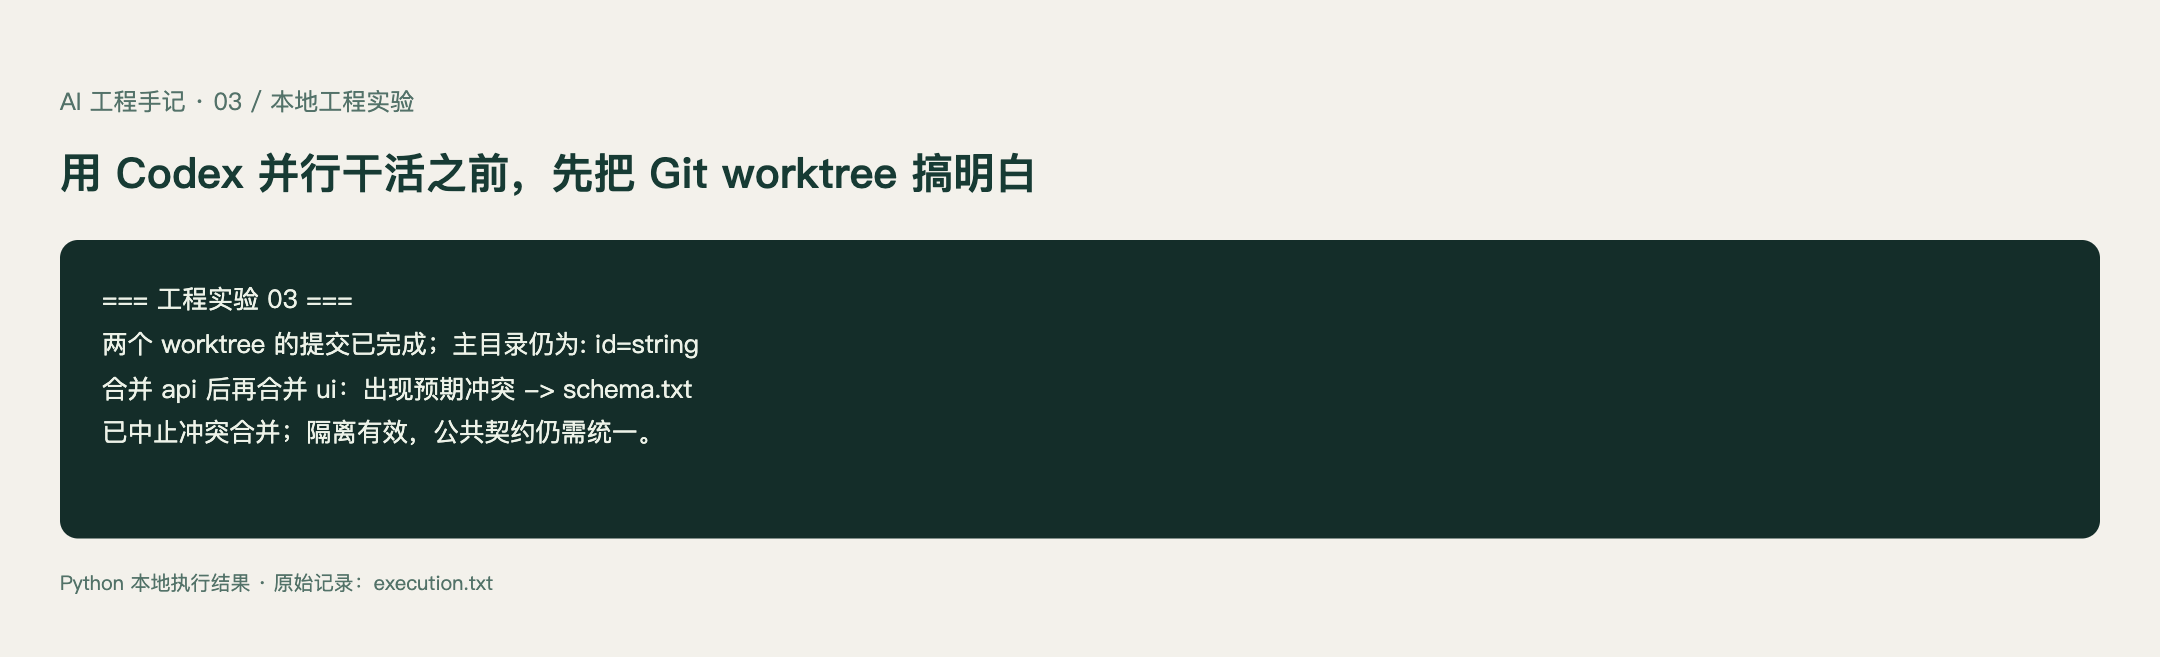
本地执行记录。完整代码:lab_v2.py,代码见文末。
自己在项目中使用时,核心命令是:
1 | git worktree add -b task/api ../project-api |
以上是操作示例,需要在已有 Git 仓库内执行。分支和目录已存在时应换名;不要为了重跑示例删除正在使用的目录。
把交付接口写在任务前面
只说“你做后端、你做前端”还不够。前端需要知道字段、错误码和分页规则;后端需要知道哪些行为已经被调用方依赖。接口不稳定时,把两边同时放出去,只会把沟通成本推迟到合并阶段。
我通常先要求一份小契约:输入字段、输出字段、失败响应,以及一份双方都能读取的示例。契约确认后,再分开实现。
| 事项 | 需要隔离或约定的内容 |
|---|---|
| 文件 | 每项任务独立 worktree |
| 服务 | 不同端口,必要时独立测试数据库 |
| 依赖 | 使用锁文件并记录安装方式 |
| 交付 | 提交 ID、验证命令、未解决问题 |
| 合并 | 指定一个集成人,避免互相覆盖 |
并行进度不能只看完成数量
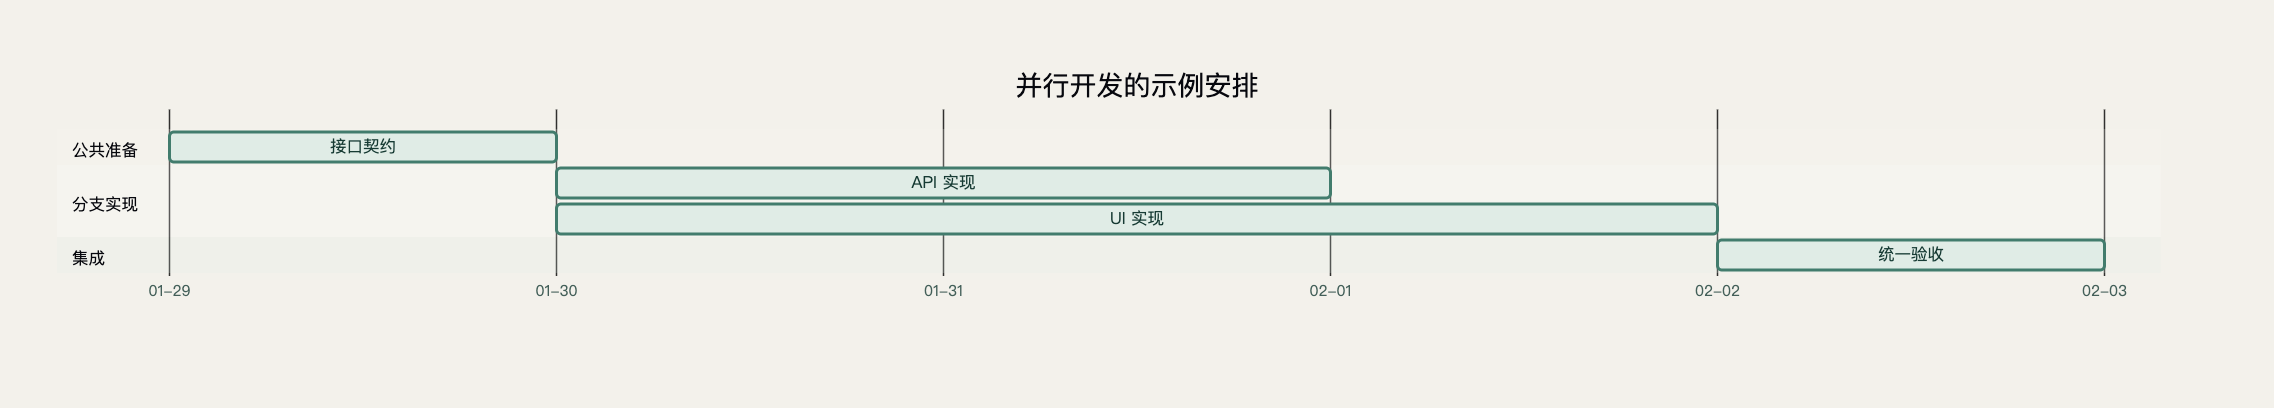
图里刻意保留了“统一验收”这一步。两项任务各自通过测试,不代表放到一起还正确。比如一边把 user_id 改成数字,另一边仍按字符串序列化,单测可以各自通过,集成却会失败。
我会要求 Agent 最后交付三样东西:改动说明、可重复执行的验证命令、已知限制。截图只能辅助定位,不能替代提交和测试结果。
目录隔开了,意见还是可能打架
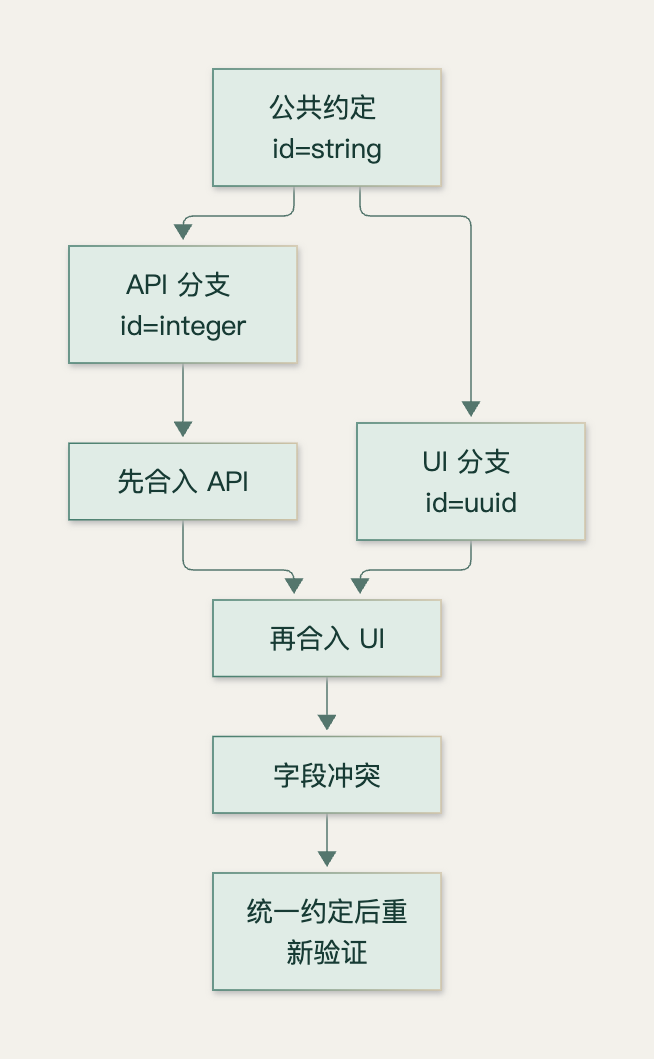
设想项目里有一份接口约定:
1 | id=string |
API 分支认为 ID 应该改成整数,于是提交 id=integer;UI 分支认为 UUID 更合适,于是提交 id=uuid。两边各自在独立目录里修改,都没有覆盖对方的文件。
这说明 worktree 的隔离生效了。但把两个提交合到一起,Git 仍然必须问:最后究竟采用哪种表示?
这次的本地实验故意制造了这个情况。脚本先建立临时仓库,再生成两个分支提交;合入第一项后,第二项产生预期冲突,最后中止合并,保留现场可解释性。
1 | git worktree add -b task/api ../project-api |
这两条命令解决工作目录和分支的问题。字段类型最终怎么定,依然要在公共契约里明确。把业务决定留给合并工具,通常会把问题拖到最后才暴露。
公共部分先定下来,剩下的再并行
我会先让 Agent 交付一份尽量小的契约:
1 | { |
再补上两个失败例子:资源不存在怎么返回,没有权限怎么返回。确定这层以后,API 可以实现存取,UI 可以实现列表和错误提示,测试也有统一参照。
如果实现过程中必须调整字段,就把它当作一次公共接口变更处理。通知依赖方、更新样例、补检查,而不是让每个 Agent 在各自目录里悄悄适配。
我会让每项任务交一张小卡片
| 卡片字段 | 示例 |
|---|---|
| 目标 | 实现用户列表分页 |
| 可改范围 | API 模块和对应测试 |
| 公共约定 | id 为字符串;分页从 1 开始 |
| 验证方式 | 固定测试命令与失败样本 |
| 交付记录 | 提交 ID、结果、尚未解决的问题 |
这样的描述不复杂,却能减少大量来回解释。你看到分支完成时,也知道应该检查什么,而不是先花十分钟猜它改动的边界。
别让两个目录共用同一套副作用
worktree 很容易给人一种“环境也隔开了”的感觉。其实两份目录仍可能连接同一个数据库、写同一处缓存、监听同一个端口。
比如 API 分支在跑测试时清空了开发数据库,UI 分支的页面就突然没了数据。你可能会以为是前端刚才的修改有问题,实际上故障来自另一个目录里的命令。
我会给每个任务单独配置端口和测试数据空间。启动时把实际使用的配置打印清楚,少依赖隐藏在用户目录里的默认设置。
1 | API worktree:端口 8101,测试数据 namespace=task_api |
这些是配置示例,不要求每个项目都照搬。要点是识别共享的副作用,再决定哪里需要隔开。文件隔离、进程隔离和服务隔离是三个不同的问题。
审查时先看行为,再看改了多少行
Agent 很容易顺手整理附近代码,最后一个小功能带出大量无关修改。审查者先看文件数和行数,常常会被工作量吸引;更该先问的是:哪些用户行为发生变化?
我会要求它用几个具体例子解释前后差异:正常分页是什么结果,空列表怎么显示,接口超时能否重试。再回到 diff,检查改动是否服务这些目标。
对于未解决的问题,必须留在交付卡片上。不能把测试失败简单改成跳过,也不能因为另一个分支正在处理,就把它算成已经完成。
已经冲突了,怎么恢复节奏
先停止继续合并,找出公共约定是哪一项没有统一。涉及字段类型时,先决定项目最终采用哪种类型,再让两边依照同一决定修改。
不要让两个 Agent 各自“智能解决冲突”后再提交一次。它们可能都消除了文本冲突,却保留了不同的业务理解。
确认结果以后,在集成目录重新跑检查,再记录最终提交。原分支可以保留一段时间用于追溯,等交付确认后再清理。清理目录前先看有没有未提交文件,别把临时排查记录一起丢掉。
这套过程看起来比点一个合并按钮多几步,但它能让每次返工都回到一个明确原因。并行任务越多,越需要这种能重新站稳的位置。
合并之后,还要再跑一遍用户路径
一个常见误区是:两个分支各自通过,就等于项目已经通过。实际上,单独测试很可能只验证了各自假设成立。
集成时至少跑一遍真实路径:创建记录、加载列表、翻页、处理失败,再看数据有没有完整往返。接口字段、默认值和缓存行为,往往就是在这里露出不一致。
并行的确可能帮你更早拿到几个候选结果,但注意力仍然有限。我会先从两个独立任务开始,确保自己有时间把它们审完。等任务描述、交付和集成检查都稳定了,再考虑增加并发数量。
能让 Agent 忙起来很容易,让自己始终知道项目处在哪一步,需要的是另一套习惯。
完整实验代码
保存为 examples/lab_v2.py 后,使用前文命令运行。
展开完整 Python 示例
1 | import argparse,csv,hashlib,io,json,subprocess,tempfile |
延伸阅读
- OpenAI 官方更新记录:Codex app 发布条目,2026-02-02。
- 宝玉:Claude Code 团队的 10 个内部技巧,2026-02-03。
- openai/codex 同期提交,2026-02-06。