2026 年 2 月 3 日
有些要求很短,却会在每次任务里重复出现:先查字段,别覆盖源文件,金额用分,遇到冲突先列出来。
单独看都不难记,放到十几次对话里,就变成了持续解释和持续纠正。你真正想保留下来的,是一套已经磨合过的做事方法。
最近 Skills 在中文技术圈的讨论,恰好落在这个问题上。卡兹克 1 月 22 日的介绍里,把选题流程拆成几个技能,并强调它的载体是包含指令、参考材料和脚本的文件夹。相关观点
GitHub 上已经能找到官方示例。anthropics/skills 在去年 12 月的提交里加入了规范链接,并整理编写与接入文档。同期版本 因此,今年值得聊的不是“一个新文件名”,而是怎样把散落在聊天记录里的经验,整理成能复用、能检查的工作资产。
我会从一个很窄的任务开始:CSV 对账。先把重复、冲突和金额单位说明白,再去想以后怎么扩展。
先写一个足够窄的 Skill
我不会把第一个 Skill 命名为“全能数据专家”。名字越大,触发条件和验收标准越难说清。
更实用的起点是 csv-audit:只处理包含 id、amount 的 CSV,只做重复与金额检查。目录最少需要 SKILL.md,其中包含 YAML 元数据和操作指令。脚本、参考文档与模板按需增加。官方示例
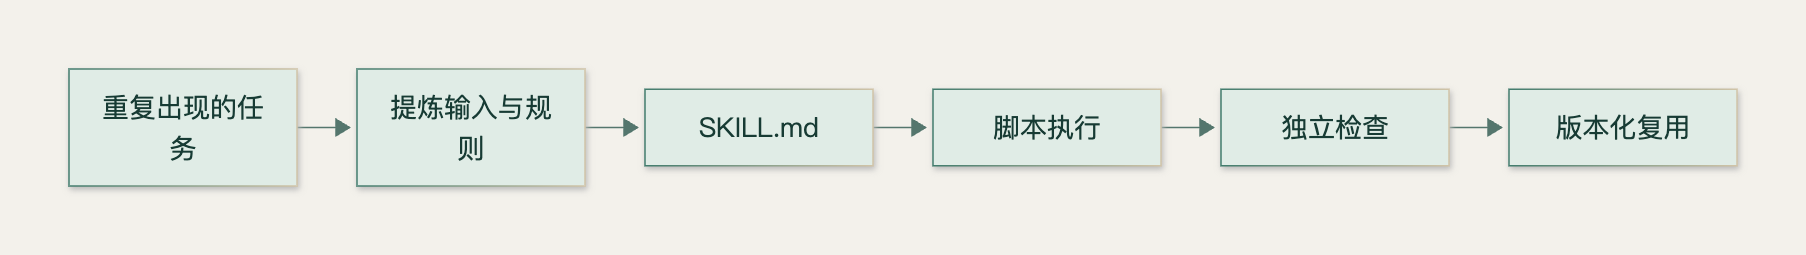
生成一份能落盘的任务说明
本例在 examples/output/csv-audit-v2/csv-audit/ 创建 Skill 文件,并检查名称、目录和必要元数据;随后运行对账规则的确定性验收。
在系列目录下运行,需 Python 3.10+:
1 | python3 examples/lab_v2.py 04 |
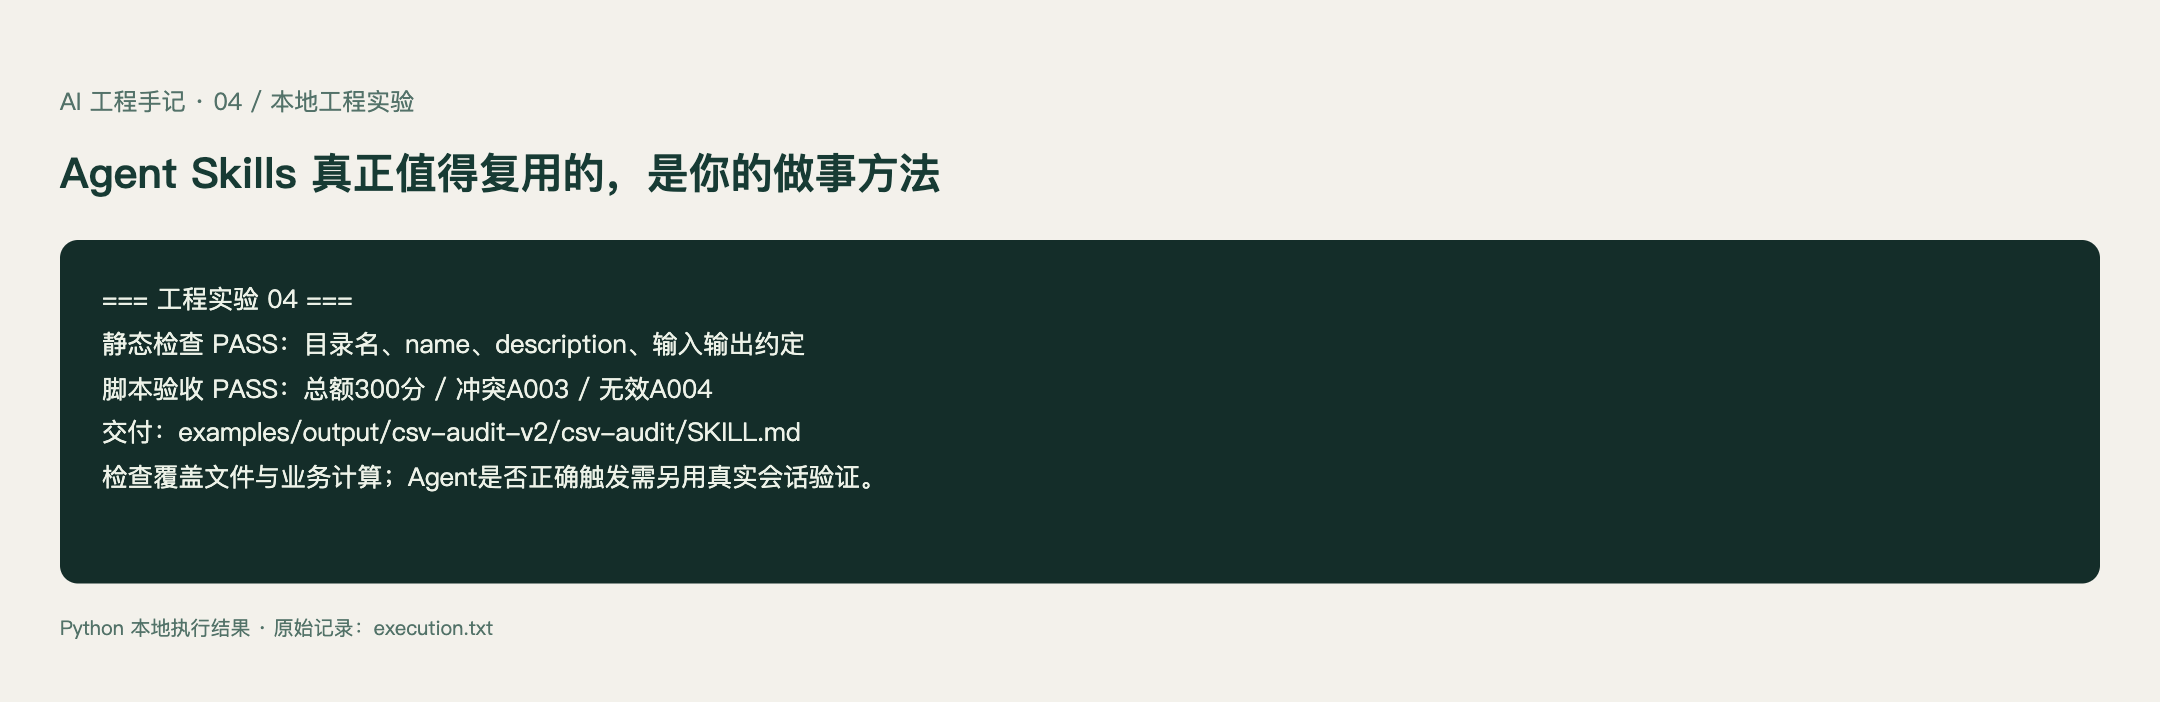
本地执行记录。完整代码:lab_v2.py,代码见文末。
生成内容的核心约定是:
1 |
|
正文再写输入、步骤、输出、验收。description 要告诉系统“什么时候使用”,不能只写“高效、专业、智能”。名称满足格式,也不代表描述足够容易触发,需要用真实用户问法试。
流程交给指令,确定性计算交给代码
排序、去重、加总这些操作,没必要要求模型在文字里一步步算。Skill 负责声明规则和调用时机,脚本负责精确执行,最终输出留给检查器验证。
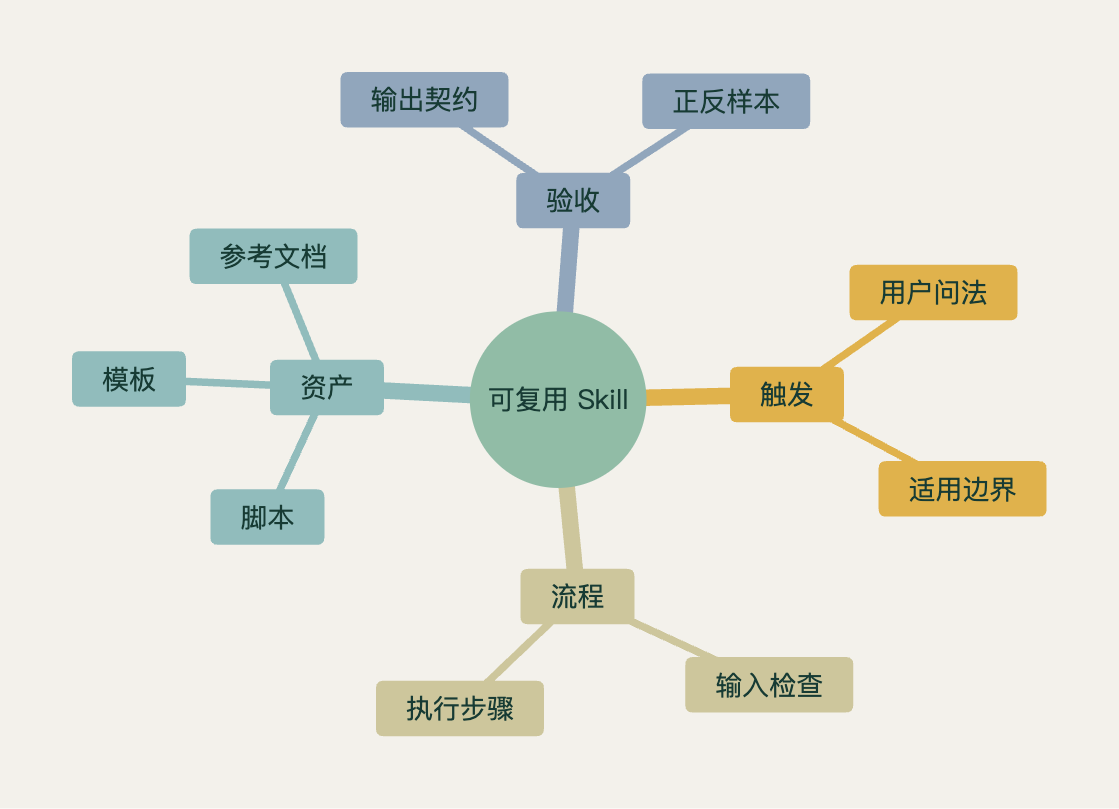
三层分开之后,排错会容易很多:没有触发,先改描述;触发但走错流程,查指令;算错金额,查脚本和单位。把所有问题都归为“模型不够聪明”,很难积累可复用经验。
| 资产 | 应该放什么 | 不应该承担什么 |
|---|---|---|
| SKILL.md | 触发条件、步骤、验收 | 假装能授予系统权限 |
| scripts/ | 确定性计算和格式转换 | 隐藏业务决定 |
| references/ | 字段说明、业务规则 | 每次无差别全部加载 |
| assets/ | 模板、固定资源 | 私钥和用户敏感数据 |
怎样判断一个 Skill 有用
至少准备三类输入:应该触发、相似但不该触发、缺少必要信息。分别观察它有没有调用、有没有追问缺失字段、有没有按格式输出。
然后用同一批任务比较“有 Skill”和“无 Skill”。观察通过率、返工次数和运行成本。只展示一次成功截图,很难说明复用收益。这里给出的本地校验也只是简化检查,不替代规范验证器和行为评测。
把“专家人设”换成一套可走通的动作
假设你写了一个“资深数据分析专家”提示词,要求它专业、严谨、避免错误。这些话几乎可以贴到任何任务上,却没有说清今天这份表应该怎么处理。
更有帮助的是下面这类约定:
1 | 输入包含 id 和 amount;amount 的单位为整数分。 |
它没有宏大的角色设定,但每一句都能对应到一个检查。把这些规则写进 Skill,交给下一次任务使用,复用才有了明确内容。
最小目录不需要很复杂
1 | csv-audit/ |
先有 SKILL.md 就可以起步。只有脚本、规则文档或模板确实需要独立维护时,再加对应目录。目录结构是为了减少重复,不是为了显得完整。
比如金额规则经常改,放到 references 方便维护;排序、聚合、去重适合放脚本;交付报告有固定格式,就留一份模板。Agent 在需要时读取,不必每次把所有材料塞进对话。
这个版本多做了一步:指令后面接验收
之前只检查文件名和元数据还不够。这次实验会生成 Skill 文件,再用同一份规则处理六行对账数据。预期结果包括:金额 300 分、A003 是冲突、A004 是无效输入。
1 | assert report['amount_cent'] == 300 |
它能帮助你发现指令和脚本是不是在讲同一件事。比如指令写着“冲突单独列出”,脚本却只保留第一条,验收就应该立即挡住。
不过静态检查通过,只代表这份资产内部能对上。真正放进 Agent 之后,还要试它会不会在合适的任务里使用、会不会主动追问缺失字段。那是下一层行为检查,需要用真实会话观察。
好的触发描述,要包含不适用的边界
我会准备三组问法:
| 用户请求 | 期望行为 |
|---|---|
| 帮我检查这份 CSV 的重复单号 | 使用这个 Skill |
| 解释什么是 CSV | 直接解释,不必执行对账 |
| 帮我算金额,但没有给文件 | 先索要必要输入 |
如果“解释 CSV”也开始创建报告,触发范围可能太宽。如果拿不到文件就随手造一份数据交差,输入要求还不够明确。
这些例子不一定要先自动化成复杂评测。把典型请求存下来,改过 Skill 后再重复试,已经能帮助你避免很多退步。
从一次纠错里提炼规则,别抄整段聊天
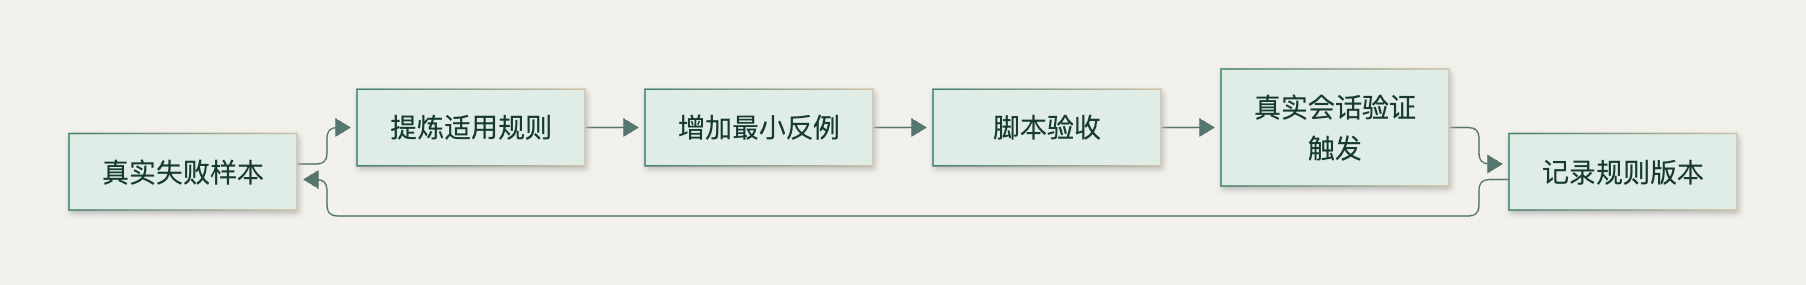
Skill 的内容通常不是一次写好的。第一次处理文件时,你可能才发现“金额单位为分”没有讲清;第二次才发现冲突记录不能随手去重。这些纠正很适合沉淀,但不必把原聊天全部搬进去。
我会先提炼成一条可执行规则,再补一个能说明问题的样本。例如:
1 | 规则:同一 id 出现不同金额时,暂停计入可确认合计。 |
这比“以后注意不要乱算”更容易被下一次任务使用。规则说行为,样本说边界,检查说怎么确认。
如果纠错只针对某一个客户的特殊规则,不要不加区分地写进全局 Skill。放到对应项目的参考文件里,并在任务输入中说明适用范围,避免别的任务继承一个不属于它的限制。
把可复用部分和用户数据分开
模板、字段规则和通用脚本可以共享,原始账单通常不该跟着共享。一个 Skill 文件夹如果塞满真实业务数据,复制时就容易把本不需要的内容一起带走。
我会使用经过处理的最小样本,保证它能复现问题,又不依赖客户姓名、账号或原始票据。执行脚本从任务传入路径读取输入,而不是把某台电脑的绝对路径写死。
1 | 规则资产:可以随项目版本管理 |
这样同一套 Skill 换一台机器也更容易工作。失败时能分清是资产缺失、输入没提供,还是环境没有配置,而不必猜作者电脑上原来放了什么。
一个 Skill 做到什么程度,就可以先用了
我会看三个条件:有人能看懂它的用途,一组固定样本能通过,失败时能指出缺少什么。满足这些,就可以先用于一个范围明确的任务。
不必一开始就支持所有格式、所有语言和所有客户端。适用范围写窄一点,反而更容易形成可靠经验。以后遇到新的重复需求,再决定扩展现有 Skill 还是拆出另一个。
维护一份小而清楚的方法,比维护一套什么都懂却没人敢改的长说明,更有持续复用的机会。
版本更新,也要跟着业务规则走
当规则从“重复单号只保留第一项”改成“金额不一致就上报”,应该更新版本说明和样本,而不是只偷偷改一段提示词。否则同事拿到新报告时,会以为总额变化是模型不稳定。
我会在交付里留下规则版本、输入文件标识和异常清单。长期看,这些记录比一个漂亮的技能名字更值钱。你知道哪条经验改善了结果,也能在新需求出现时有依据地修改。
Skill 最适合沉淀的,是反复出现、已经想清楚、以后还会继续用的方法。先让一个小任务少解释几遍,再慢慢增加能力,通常会比先造一个“全能专家”更快见到效果。
完整实验代码
保存为 examples/lab_v2.py 后,使用前文命令运行。
展开完整 Python 示例
1 | import argparse,csv,hashlib,io,json,subprocess,tempfile |
延伸阅读
- Anthropic Skills 官方示例历史版本,2025-12-20。
- 数字生命卡兹克:一文带你看懂 Skills,2026-01-22。
- anthropics/skills 同期提交,2025-12-20。