2024 年 10 月 24 日 · Redis 深度实践 02
接口耗时 80 毫秒,慢日志里却只有几个微秒。这时候只重复“Redis 在内存里,所以很快”,对排查几乎没有帮助。
我更愿意把一次 GET 拆开:请求先在应用里等连接,再穿过网络,进入 Redis 的处理队列,执行查找,最后把结果送回来。哪一段变长,决定了该改客户端、命令,还是机器配置。
本文仍用 Redis 7.2.6。先看原理,再用一条真实 TCP 连接做对照实验。性能数字只解释这组实验,不把本机吞吐当成生产指标。
一条 GET,经过的东西比哈希表多
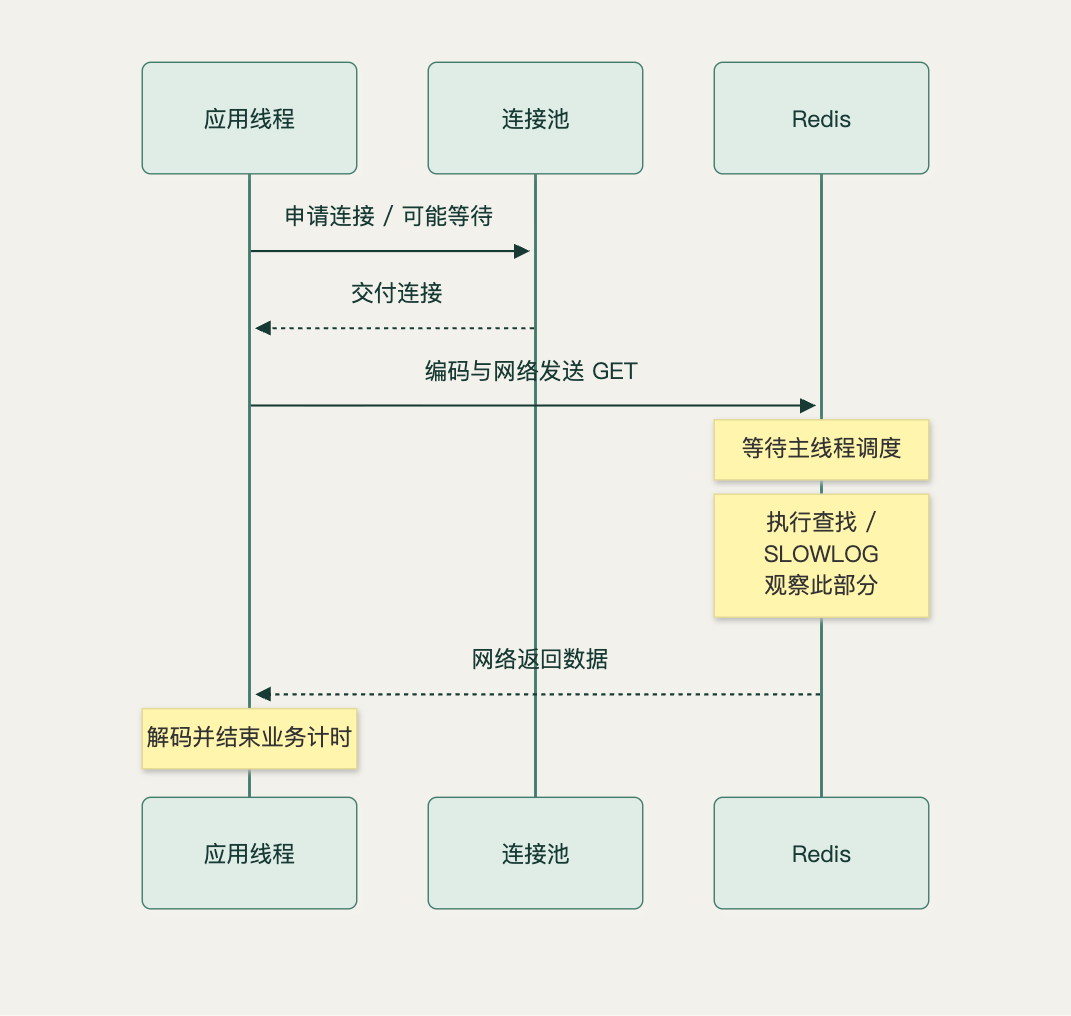
可以先用一个粗略公式建立排查顺序:
1 | 端到端耗时 ≈ 连接池等待 + 请求编码 + 网络传输 |
GET 在哈希表里找到 Key,只是中间一小步。大 Value 的复制和返回、应用线程的调度、连接池被占满,都可能比这一步更贵。TLS 和跨可用区访问也会改变端到端结果;比较前先固定拓扑和协议。官方延迟排查文档
Redis 的优势是这些成本被压得比较紧:主要数据放在内存里,常见操作走合适的数据结构,网络连接通过事件循环调度,普通命令执行路径不用给每个请求都建线程。它没有因此获得“每条命令都恒定耗时”的特权。
单线程说的是主要命令执行路径
在本文讨论的普通数据命令路径里,一个实例主要由主线程串行执行命令。这让共享数据的修改顺序容易确定,也省掉了每次操作都争用数据锁的成本。但进程里还有后台任务和可选的 I/O 线程,不能把它说成“Redis 只有一个线程”。
7.2.6 的配置里,io-threads 默认是 1;把线程数调大后,可把部分网络工作交给 I/O 线程。io-threads-do-reads 默认是 no,读请求是否也使用线程需要单独设置。I/O 线程不意味着多个普通命令开始并行改同一份数据。 配置注释和网络处理实现对此划分得很清楚。
这也解释了为什么一条重命令可能让许多轻命令一起等:它们共享主要执行路径。一个大集合交集、一段跑太久的 Lua、一次返回很多成员的操作,都有机会把其他请求拖在后面。
所谓 I/O 多路复用,则是在一个事件循环里管理许多连接:哪些可以读、哪些需要写,等就绪后再处理。Linux 里的 epoll 和 macOS 的 kqueue 是不同的平台后端。它解决连接调度,不会把一个 O(N) 操作自动变成 O(1)。事件循环源码
数据结构和内存布局,决定每条命令要干多少活
前一篇已经测过小 Hash 的 listpack 编码。连续内存能减少指针和分配开销,也更有利于局部访问;代价是某些操作需要扫描或移动元素。超过阈值后转为哈希表,就是在时间和空间之间切换。
大结构也有类似取舍:List 使用 quicklist 组织节点;ZSet 的一般编码把字典和跳表组合起来,兼顾成员定位与有序访问。它们解决的是不同操作的成本,不能只凭“内存数据库”四个字推导性能。List 实现、ZSet 实现
我会把命令复杂度转成一次请求的工作量。例如 HGET 取一个字段和 HGETALL 取十万个字段,调用次数都算一次,但 CPU、返回字节和网络占用完全不同。读多写少的服务,往往先限制返回量,比先调整线程数更有效。
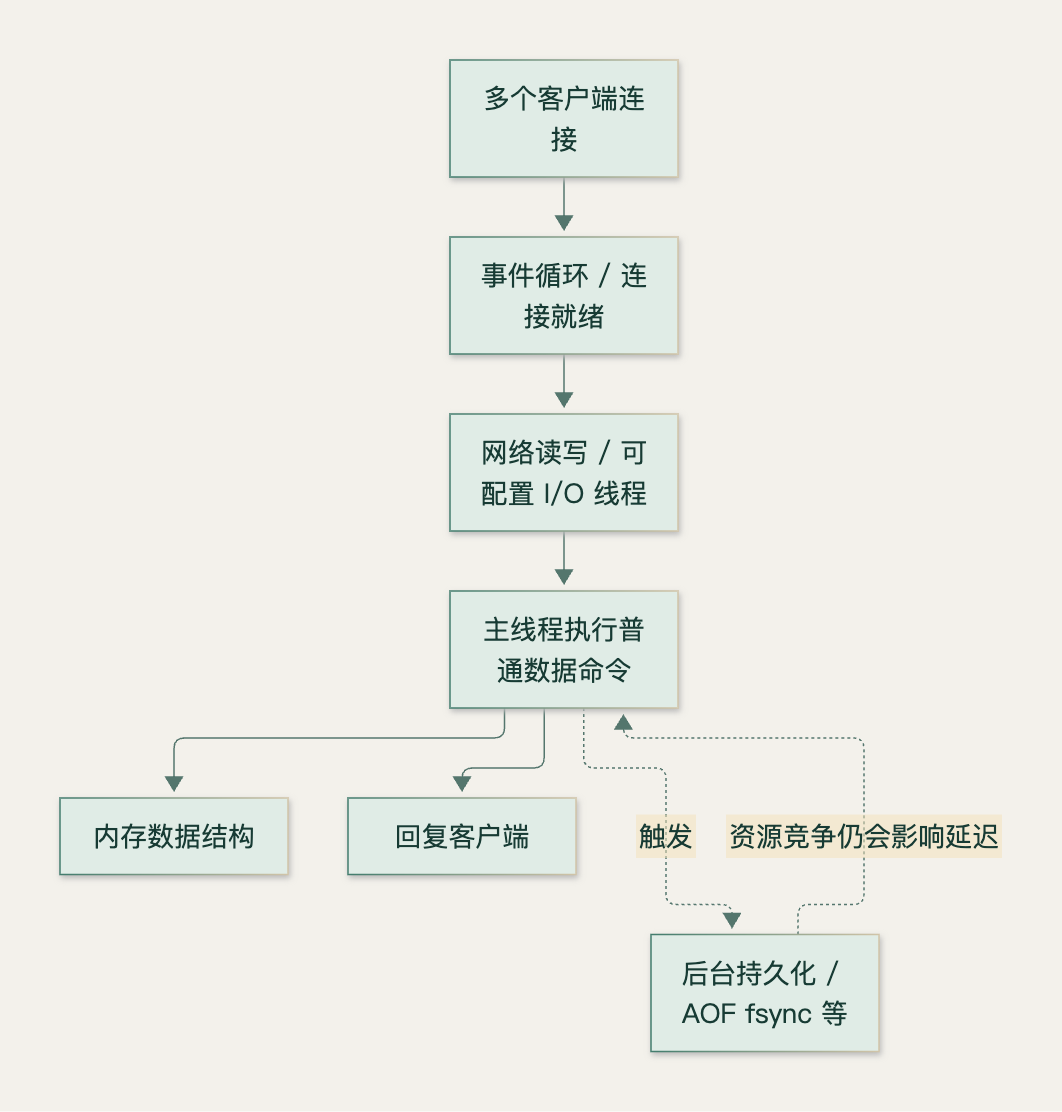
后台任务也不是没有影响。生成 RDB 或重写 AOF 时,父进程 fork、写时复制和磁盘压力都可能反映到延迟上。看到 CPU 没满,仍然要继续看磁盘、换页和 fork 指标。
Pipeline 的主要收益,是少等几轮
串行客户端通常这样工作:发一条 GET,等回复,再发下一条。假设网络往返时间是 0.8 毫秒,忽略其他成本,一条连接按这种方式每秒也只能完成约 1,250 轮。
Pipeline 允许先发送一批命令,再读取回复。Redis 仍按自己的执行路径处理命令,但客户端不必为每条命令单独等一个往返;多个请求和回复也能减少系统调用开销。官方 Pipeline 说明
我做的实验固定了以下条件:单客户端、同一条 127.0.0.1 TCP 连接、一个 64 字节的 Value、每轮 12,000 次 GET。先预热,再把批次 1、64、256 的测试顺序打散,各测三轮,取整批耗时中位数。没有 TLS,没有持久化写入,也没有外部并发。
| 每批命令数 | 三轮整批耗时中位数 | 按整批耗时折算的吞吐 |
|---|---|---|
| 1 | 221.292 ms | 54,227 次/秒 |
| 64 | 19.779 ms | 606,708 次/秒 |
| 256 | 16.666 ms | 720,027 次/秒 |
这组结果足以说明:在这个轻命令场景里,逐条等待占了很大一部分成本。它不能说明“生产一定提升十几倍”,更不能拿批量总耗时除以请求数,称为单条请求的 P99。
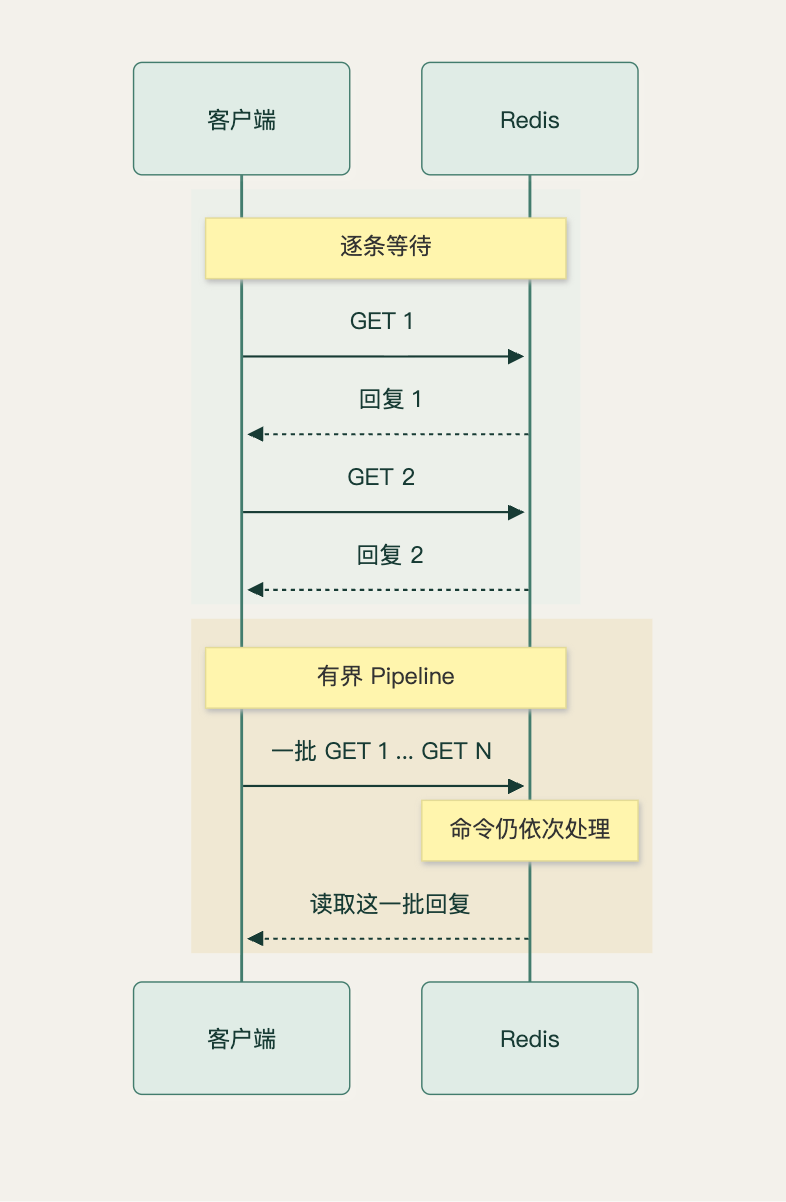
Pipeline 还要控制批量大小。一次堆几十万条,大回复会占用服务端输出缓冲、客户端内存,并让前面的请求等到整批读取时才被应用消费。我一般从几十到几百条试起,同时限制批次字节数和最长等待时间;交互式请求和离线批处理的目标也不同。
如果客户端库提供 pipeline(),还要确认是否默认开启事务。例如有些库需要显式传 transaction=False,才能得到这里比较的普通批量发送语义。
Pipeline、MULTI 和 Lua,分别解决什么
| 手段 | 主要解决的问题 | 不能顺便得到的保证 |
|---|---|---|
| Pipeline | 减少逐条等待和网络调用 | 整批原子性、自动回滚 |
| MULTI/EXEC | 执行队列时不让其他客户端命令插入 | 数据库式的运行时错误回滚 |
| WATCH + MULTI | 检查 Key 是否被修改后再提交 | 自动替你处理冲突重试 |
| Lua | 在服务端完成有条件的多步操作 | 跨数据库事务、超时后的自动撤销 |
下面这段特别适合亲手试:
1 | SET demo:wrongtype text |
INCR 在 EXEC 中发生类型相关的执行错误,但后面的 SET 仍然成功,最后能读到 written。这是本次实验实际检查的行为。排队阶段就发现的语法错误和运行时错误,处理方式还不一样。官方事务说明
Lua 的“原子”也值得仔细理解:脚本执行期间其他客户端不会插入普通命令,但脚本已经做了写入,随后又发生运行时错误,前面的写入不会自动回滚。涉及金额、库存或计数时,先验证参数和数据类型,再开始修改;脚本长度和循环上界也得控制。脚本执行语义
慢日志很干净,我会沿着边界继续查
慢日志记录的是命令执行部分的耗时,不包含与客户端通信的全部时间。一次 GET 在慢日志里显示 0 微秒,表示这个采样落在计时精度内,不表示端到端零延迟。SLOWLOG GET 说明
我的排查通常按这个顺序展开:
- 确认测量位置。 是请求总耗时、连接池等待、socket 等待,还是 Redis 执行?先让应用指标带上阶段信息。
- 看慢命令与大回复。
SLOWLOG GET、INFO commandstats,结合 Key 的成员数和返回字节;慢日志会包含命令参数,采集时留意业务数据。 - 看事件和资源。
LATENCY LATEST/DOCTOR、INFO persistence、INFO memory,以及机器的 CPU、磁盘和换页。 - 再调整配置。 分批、拆大 Key、修客户端连接管理,或评估 I/O 线程。每次修改都留下前后对照。
下面是一组只读诊断命令;启用延迟事件采样则是配置修改,应按自己的变更流程执行:
1 | redis-cli -p 18379 INFO commandstats |
SCAN 能把全量扫描拆成多次,但 COUNT 是工作量提示,不是每次返回条数上限;遍历中还可能遇到重复。替换 KEYS 时,消费端需要去重或保证处理幂等,也要限制扫描速率。SCAN 的保证范围
Linux 上还可以在 Redis 所在机器运行 redis-cli --intrinsic-latency,估计调度等环境因素带来的基础延迟。它会占用 CPU 做测量,要在可接受的时间和环境里执行;在应用服务器上运行,不能代表 Redis 主机的底噪。
把这个实验当成排查模板
从自己的实验项目根目录执行:
1 | python3 lab/redis_lab.py performance --redis-server "$REDIS_LAB_SERVER" |
脚本会验证每条回复确实是 64 字节的预期值,还会验证 MULTI 执行出错后,后续命令仍然写入。三轮采样保留在原始结果(见文末实验记录)和执行记录(见文末实验记录)中;源码是完整实验代码(见文末)。
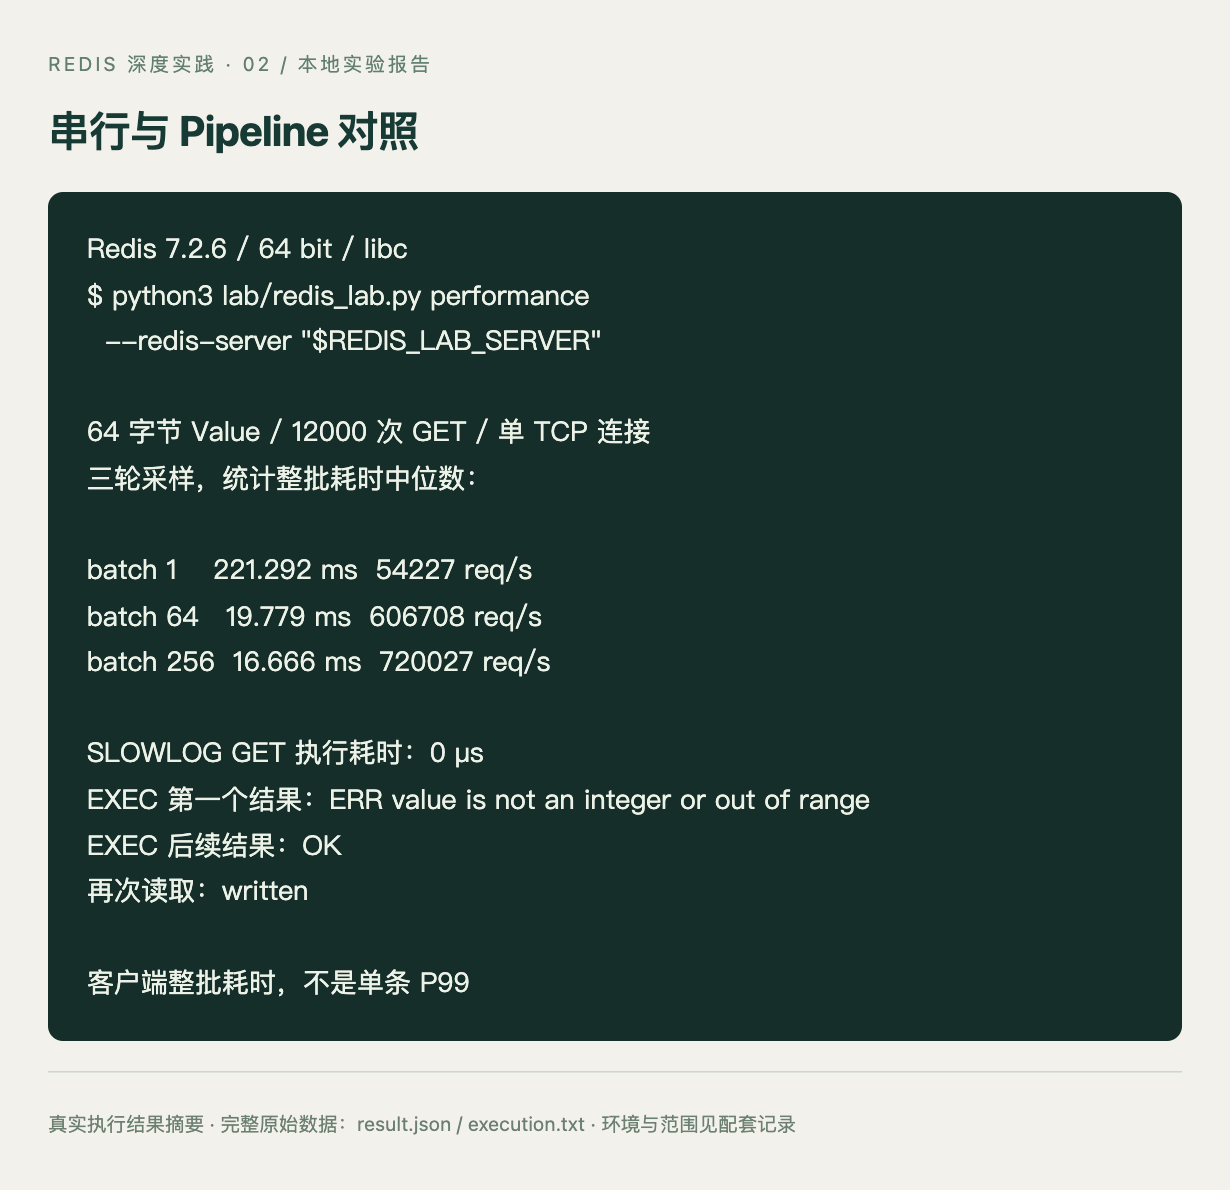
判断一个优化值不值得做,我会同时看吞吐、单请求延迟分布、错误率和资源。批处理吞吐升了,交互请求的 P99 却恶化,这种结果就要重新讨论目标。Redis 的快来自一串具体选择;排查和优化也应该回到这些具体环节。
实验环境与完整代码
先准备 Redis 7.2.6。以下操作只创建本机实验目录,需要 C 编译器、make 和 Python 3;Redis 实例仅监听回环地址。
1 | mkdir -p /tmp/redis-deep-lab-build |
在自己的实验项目中创建 lab/ 目录,把下面的 Python 代码保存为 lab/redis_lab.py,然后回到该项目根目录运行文中的命令。默认从 18379 端口开始;检测到已有服务会停止。脚本只关闭自己启动的进程,原始输出保存在项目的 assets/ 目录中。
展开本篇完整实验代码(Python 3,无第三方包)
1 | from pathlib import Path |
展开本篇实验记录
1 | { |
延伸阅读
- 7.2.6 网络处理源码、事件循环源码:核对命令执行与 I/O 的分工。
- 官方性能测试说明历史快照:理解客户端、批量、数据大小如何影响基准测试。
- Josiah L. Carlson,《Redis in Action》,第 4 章:可对照阅读 Pipeline、事务与性能取舍;本篇的数值和实验独立生成,不取用书中的基准数据。