2024 年 10 月 12 日 · Redis 深度实践 01
一个接口只是要改用户昵称,代码却先取出整段 JSON,反序列化、修改、再整段写回。过一阵,另一个接口同时改了头像,两边互相覆盖。大家开始讨论“Redis 要不要加锁”,但问题其实更早:这个对象究竟应该怎么存?
我会先问三个问题:读的时候取整条还是部分字段,写的时候有没有并发,哪些内容必须一起过期。数据结构选对,很多同步逻辑会直接消失;选错了,Redis 再快,也只是在更快地执行绕路。
本文统一用 Redis 7.2.6。这个版本在 10 月 2 日发布,下面涉及的编码和命令都按它来核对。版本记录
先写访问方式,再画 Key
假设要做一个内容社区,里面有用户资料、点赞、热榜、任务分发。我的建模草稿会先写成这样:
| 业务 | 最常见的操作 | 起步结构 | 必须额外回答的问题 |
|---|---|---|---|
| 页面缓存 | 整块读、整块替换 | String | 序列化大小、TTL、版本 |
| 用户资料 | 读写少量字段 | Hash | 字段是否需要独立过期 |
| 点赞用户 | 去重、判断成员 | Set | 成员总量会不会失控 |
| 热门文章 | 加分、取前几十名 | Sorted Set | 分数精度、并列规则 |
| 最近浏览 | 两端追加、裁剪 | List | 是否允许重复、保留多少条 |
| 后台任务 | 分组消费、确认、接管 | Stream | 重复处理、积压、保留策略 |
| 每日签到 | 按整数用户 ID 标记 | Bitmap | ID 是否足够稠密 |
| 页面 UV | 只需要近似基数 | HyperLogLog | 能否接受误差、是否需要明细 |
这张表是原创的业务选型表;命令语义可以对照官方的数据类型总览。我也会拿黄健宏的《Redis 使用手册》查应用组织方式,但具体编码以当前版本源码为准。书里的场景能复用,旧版本的内部结构图不能直接搬到 7.2 上。
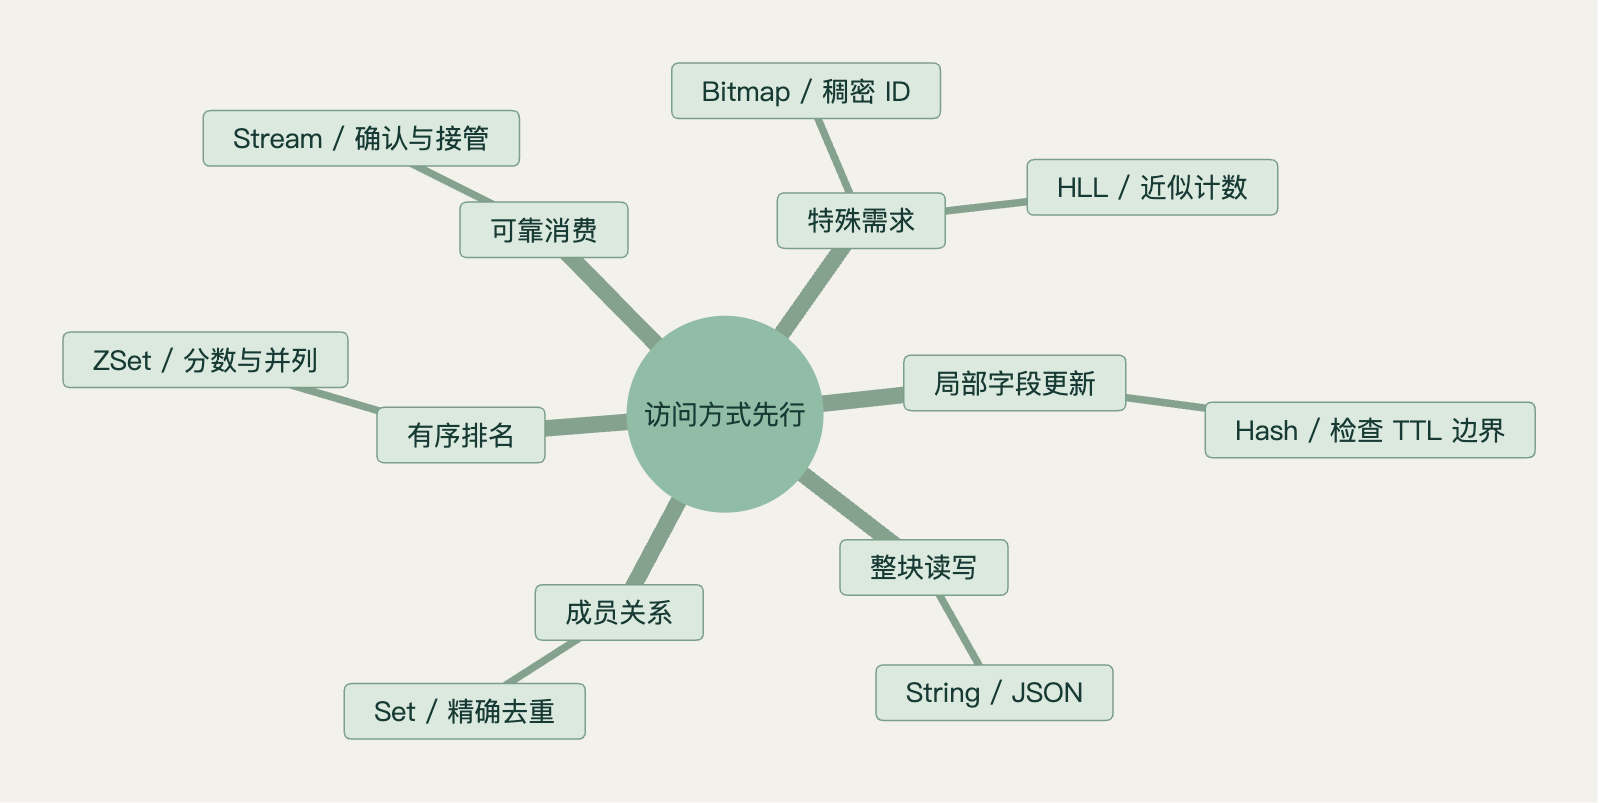
Key 名字也得顺手设计。例如 user:42:profile 比 data42 更容易定位,按日期分桶的 rank:20241012 比永久增长的 rank:all 更容易控制体积。名字不是功能,但会直接影响排障、扫描和删除的成本。
String 和 Hash,我会按更新粒度来选
页面片段、配置快照、一个无需局部更新的小对象,用 String 存 JSON 很自然。读写各一次,序列化协议也由应用掌握。
如果对象经常被不同接口更新不同字段,Hash 更顺手:
1 | HSET user:42:profile nickname Lewis avatar /avatar/42.png visits 0 |
HINCRBY 把读、加一、写回压成一条命令,避免应用自己做有竞争的 GET/SET。不过,多条相关命令之间仍可能被其他客户端插入。需要检查版本后再更新多个字段时,才继续讨论 WATCH 或 Lua。Hash 命令说明
Redis 7.2 的 Hash 不能给单个字段设置 TTL。 上面的 EXPIRE 作用在整个 Key 上。如果头像地址和临时验证码放进一个 Hash,却要求验证码五分钟过期、资料一直保留,结构已经不合适了。拆 Key 往往比维护一套字段过期清理器更省事。
String 也有一个容易漏掉的细节:普通 SET key value 会覆盖原来的 TTL。需要继续沿用 TTL 时,明确使用 KEEPTTL;需要重新计时,就在同一条 SET 中带 EX/PX。别把“上次设过过期时间”当成持久约定。SET 的过期语义
类型相同,内存占用也可能突然换一个量级
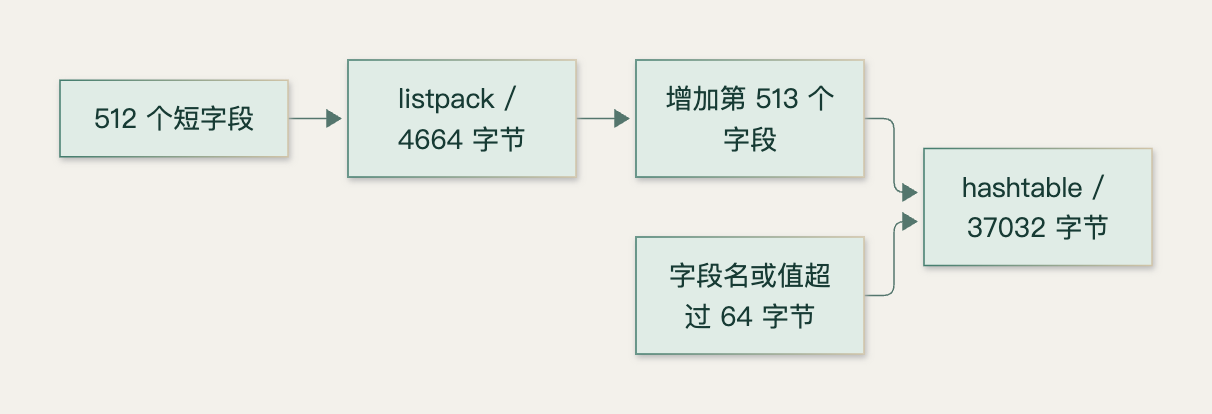
对客户端来说,Hash 一直是 Hash;内部却可能用两套编码。小 Hash 可以用 listpack 紧凑存放,满足不了条件后再转成哈希表。默认阈值是:
1 | hash-max-listpack-entries 512 |
前者限制字段数量,后者限制字段名或字段值的字节长度。这里的 64 是字节,中文不能按字符数估。UTF-8 下,一个汉字常占多个字节,字段名也算在检查范围内。7.2.6 的配置和转换代码都能直接核对。
我用同一个 Key 做了一个小实验:先放 512 个很短的字段,再加第 513 个。结果如下。
| 状态 | OBJECT ENCODING | MEMORY USAGE |
|---|---|---|
| 512 个字段 | listpack | 4,664 字节 |
| 513 个字段 | hashtable | 37,032 字节 |
只是多一个字段,这个样本的占用变成了约 7.9 倍。它不是“Hash 永远膨胀八倍”的规律,而是这组数据跨过编码阈值后的实测变化。实验使用 64 位 macOS 和 libc 分配器;Linux 上常用的 jemalloc、Key 长度、实际内容都会影响数字。MEMORY USAGE 也不是整个实例的 RSS。命令口径
同一组实验还观察到:纯整数的小 Set 使用 intset,几个短字符串组成的小 Set 使用 listpack,小 ZSet 也使用 listpack。“Set 底层一定是哈希表”这类口诀,在 7.2 上已经不够用了。 相关条件可以查历史内存优化文档。
我的处理顺序是先量分布:典型对象多少字段,P95 的字段值多长,增长后会落在哪种编码。确实存在大量稳定的小对象,再考虑分桶。把阈值一口气改得很大,可能节省内存,却让紧凑结构里的查找、移动和转换变重,得补测尾延迟。
排行榜不是把所有数字塞进 score 就结束
ZSet 适合“按分数排序,并能定位一个成员”的需求:
1 | ZADD rank:20241012 100 article:42 90 article:57 |
同一个 member 只有一份,重复 ZADD 会更新分数。分数相同时按 member 的字节字典序排列;使用逆序查询时,并列成员顺序也会反过来。业务要“同分时更早到达排前面”,需要另外设计稳定的排序规则。排序规则
我尤其会避开未经计算的 score * 10^13 + timestamp。score 使用双精度浮点数,整数只能在正负 2^53 范围内保持精确。拼接后的整数超过范围,比较结果就可能不符合预期。需要多维排序时,先算数值上界;真要维护复杂的任意条件排序,关系型数据库或搜索索引可能更合适。
热榜还要控制生命周期。按天建 Key,给旧桶过期时间,再给每桶设置排名上限,比永久累加一个大 ZSet 更可控。裁剪时要先定义“保留最高分的前 N 名”还是“最近 N 个事件”,这两种语义不能混用。
List 能弹出任务,Stream 才把待确认任务留在账上
用 List 做简单队列很方便,但 BRPOP 把任务交给消费者后,消费者崩溃怎么办?如果没有 processing 列表和确认机制,任务已经离开队列。
List 可以通过 BLMOVE 等命令构造待处理列表,但确认、超时接管和重试仍得自己做。要用消费组管理任务,我更愿意从 Stream 开始:
1 | XGROUP CREATE jobs:image workers 0 MKSTREAM |
XREADGROUP 分配消息后,消息会进入消费组的待确认列表 PEL。消费者退出,不会自动把所有待确认消息重新投给别人;要用 XPENDING 观察,再用 XAUTOCLAIM 等方式接管。生产中的最小空闲时间,应大于正常任务的处理时间上界,否则容易把还在处理的任务抢走。Stream 消费组说明
下面的实验为了快速演示,把接管空闲阈值设为 0,检查了这条链:待确认数 1 → 接管 1 条 → XACK 1 条 → 待确认数 0。这个值只适用于演示。
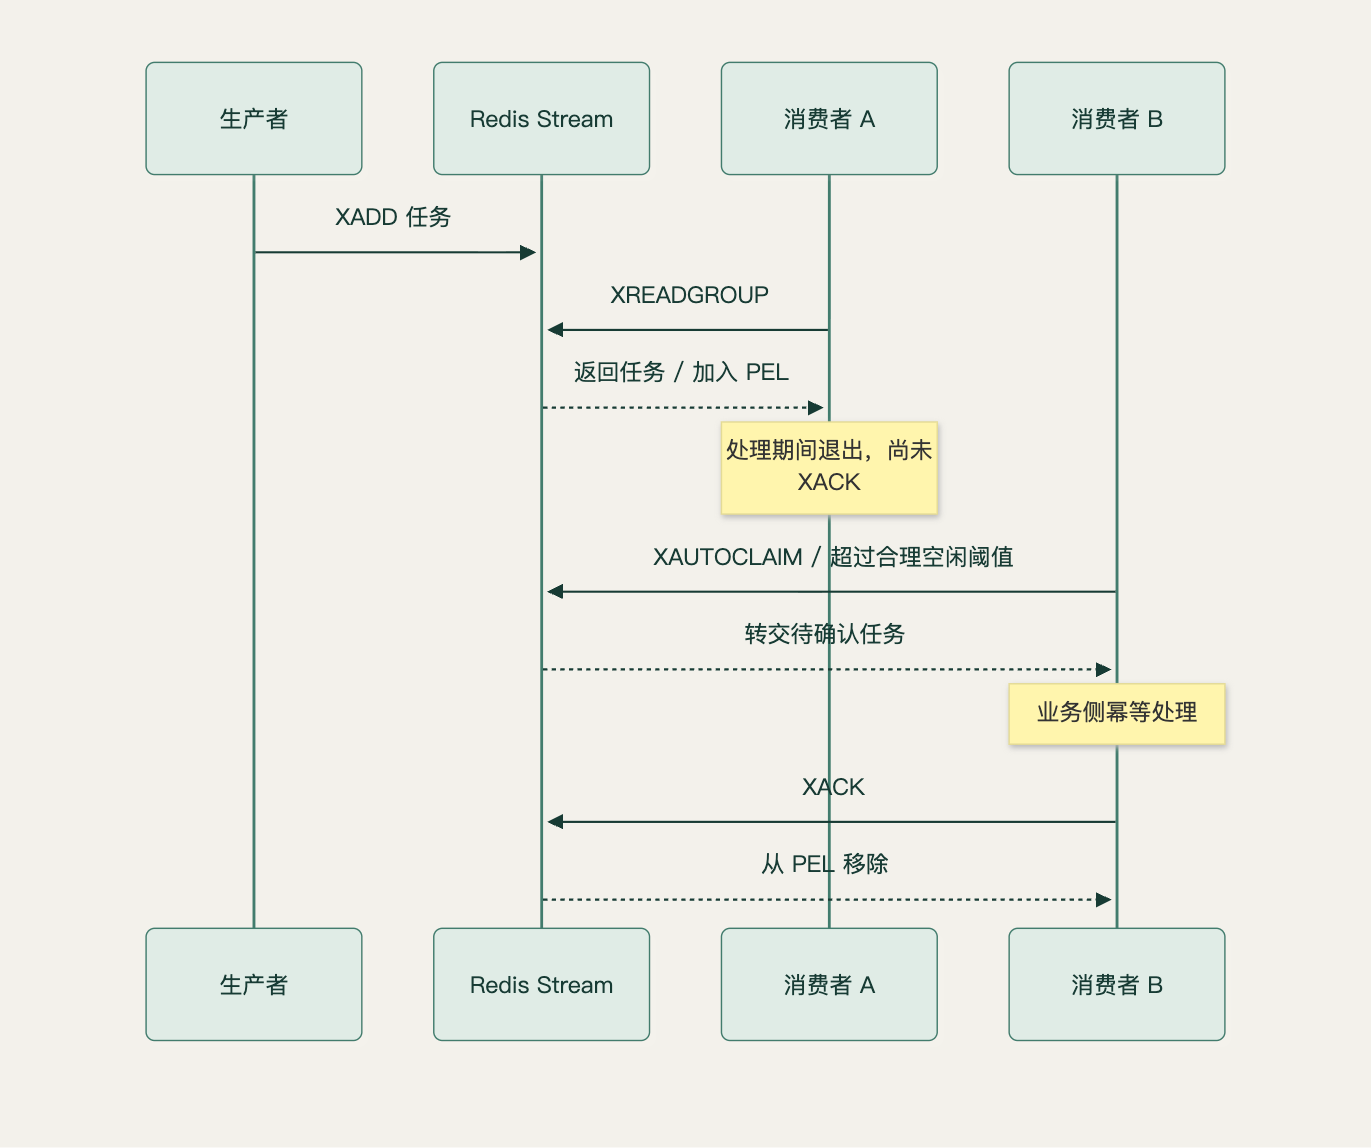
即便如此,也不能写成“消息只执行一次”。业务处理完成但 XACK 前崩溃,消息会再次被处理。我的落地办法是给任务稳定的业务 ID,在最终写入的位置做唯一约束或幂等检查。另一个问题是裁剪:MAXLEN 限制长度时,要同时考虑最慢消费组和积压,不能只看 Stream 本身占了多少内存。
Bitmap 和 HyperLogLog,省空间之前先检查需求
每天签到可以把用户编号映射成 bit:
1 | SETBIT sign:20241012 42 1 |
如果 ID 从 0 连续增长到一千万,位图很紧凑;如果直接拿一个极大的雪花 ID 当偏移,最高位会把中间空间一起撑开。先映射成稠密序号,才谈得上节省。Bitmap 说明
HyperLogLog 则适合只关心 UV 大致数量的场景。它能合并基数估计,但不能列出访问过的用户,也不能回答“用户 42 是否出现过”。需要精确成员关系时,用 Set;需要近似去重计数时,再用 PFADD/PFCOUNT/PFMERGE。别让一个节省内存的选择偷偷改变产品语义。HyperLogLog 说明
GEO 的选择也类似:附近位置检索可以考虑 GEO 命令,但复杂多边形、道路距离、地图拓扑不在同一个问题范围。结构的便利程度,取决于需求与命令能否直接对应。
跑一次,再把结构定下来
配套实验包含 Hash 阈值、Set/ZSet 编码和 Stream 接管,不会连接已有服务。先按文末的环境说明准备 7.2.6,再从自己的实验项目根目录执行:
1 | python3 lab/redis_lab.py structures --redis-server "$REDIS_LAB_SERVER" |
脚本只启动监听 127.0.0.1 的独立实例,默认端口 18379;端口已有服务会停止执行。实验结束自动关闭自己创建的进程。源码见完整实验代码(见文末),原始结果见结构实验记录(见文末实验记录)。
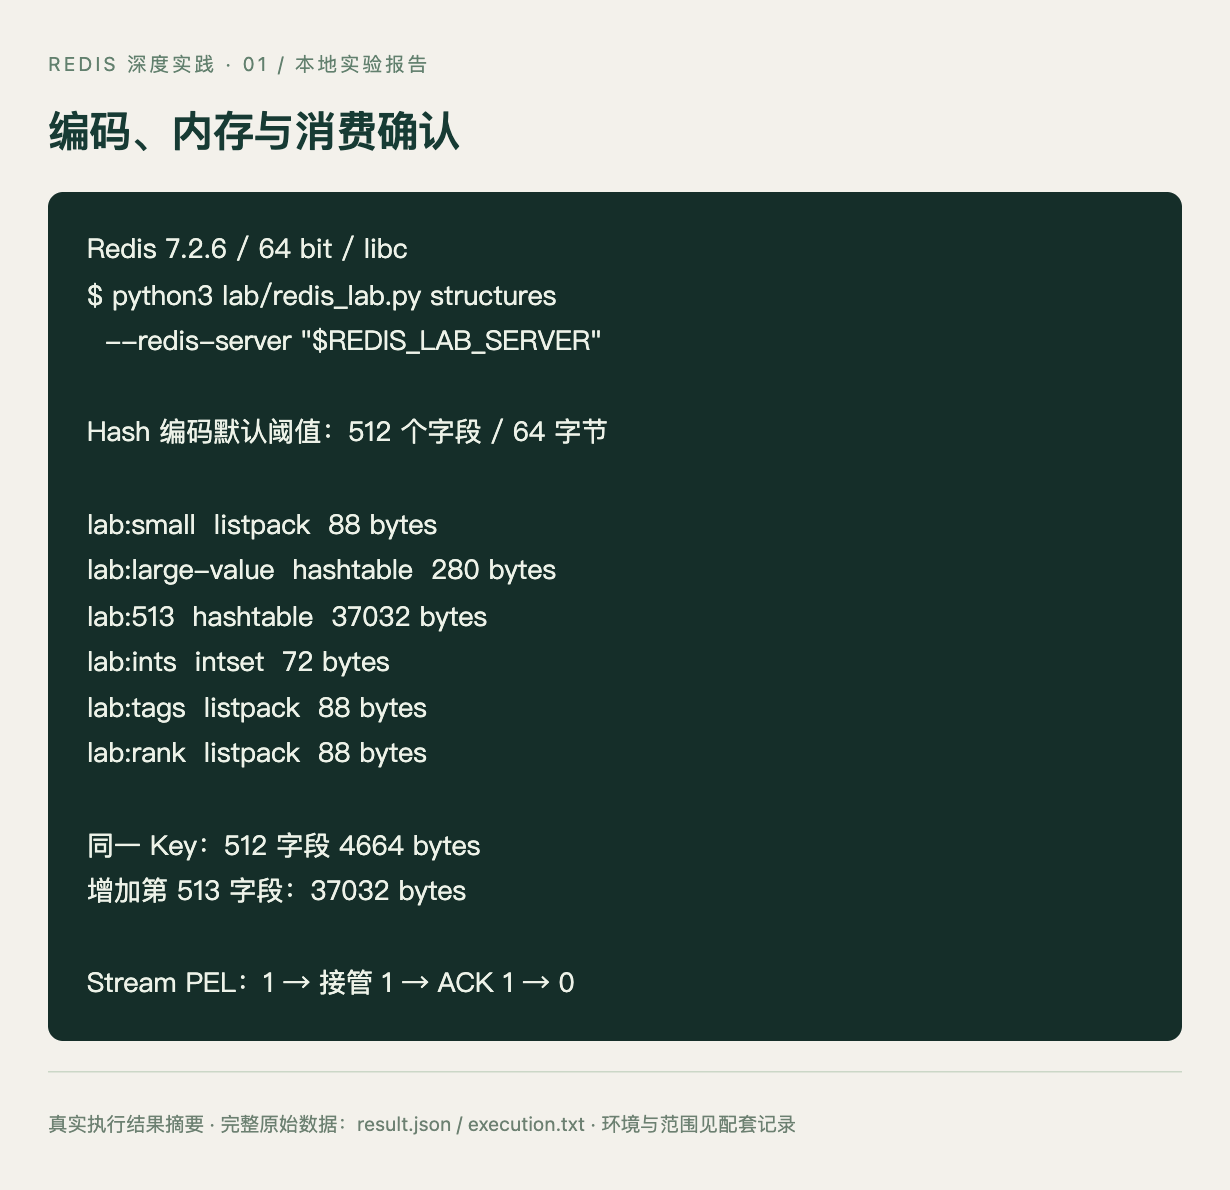
真正提交方案时,我会让每种 Key 都有这几个答案:最长保留多久、最大允许多大、谁负责清理、并发更新如何协调、要不要独立过期。把这些写进设计,再选 String、Hash 或 Stream,后面的容量和可靠性讨论才有共同的起点。
实验环境与完整代码
先准备 Redis 7.2.6。以下操作只创建本机实验目录,需要 C 编译器、make 和 Python 3;Redis 实例仅监听回环地址。
1 | mkdir -p /tmp/redis-deep-lab-build |
在自己的实验项目中创建 lab/ 目录,把下面的 Python 代码保存为 lab/redis_lab.py,然后回到该项目根目录运行文中的命令。默认从 18379 端口开始;检测到已有服务会停止。脚本只关闭自己启动的进程,原始输出保存在项目的 assets/ 目录中。
展开本篇完整实验代码(Python 3,无第三方包)
1 | from pathlib import Path |
展开本篇实验记录
1 | { |
我会放在手边的资料
- Redis 7.2.6 源码:用于核对编码、默认配置和命令实现。
- 官方数据类型文档历史快照:本文命令说明采用 2024 年 4 月前已公开内容。
- 黄健宏,《Redis 设计与实现》:适合建立“对象类型与内部编码分开看”的阅读框架。作者公开的早期网络版对应更老版本,不能据此断言 7.2 的编码。
- 黄健宏,《Redis 使用手册》:可沿应用场景查命令组合,版本差异再回到源码确认。