2026 年 8 月 20 日
Qwen3.8 的开放权重消息,让“本地助手”又多了一个值得动手的方向。但在几十 GB 的文件开始下载之前,我更想先把账算清楚。
你可能已经看到过类似建议:27B 不算太大,量化以后更容易装,选个工具就能跑。每句话单独看都没错,合在一起却容易让人跳过最重要的前提——你选的格式、机器和任务,究竟是不是同一套条件。
GitHub 上,Qwen 官方仓库 8 月 17 日的更新已经写入 Qwen3.8。同期版本 模型卡中也能找到 27B FP8 的具体文件与使用说明。历史模型卡 对准备本地部署的人来说,这些具体资产比一个抽象参数量更重要。
卡兹克 8 月 3 日谈 Qwen3.8 时,特别期待供开发者部署的 27B 版本,把小模型和生态的覆盖面联系起来。相关观点 我也觉得这个方向值得关注,但“能被更多人部署”最终还要落到机器资源和实际体验上。
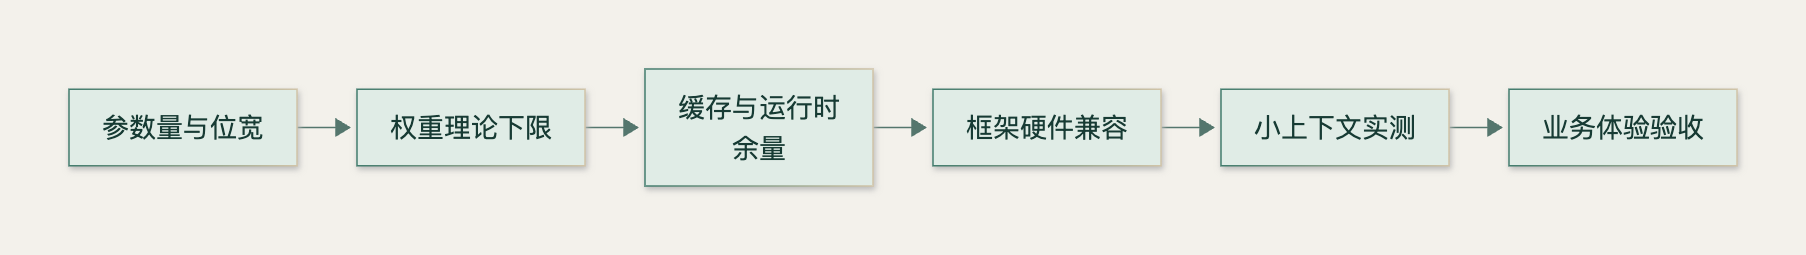
下面先做容量规划,再把启动和验收的步骤摆清楚。先不急着承诺某台机器一定够用。
先算最简单的一笔账
只考虑参数本体,公式是:参数量 × 每参数位数 ÷ 8。27B 在 16 位下大约需要 54 GB 十进制字节,折合约 50.29 GiB;8 位约 25.15 GiB;4 位约 12.57 GiB。
这些都是理论权重下限。真实文件还可能包含量化尺度、未量化层与其他组件,运行时还需要 KV cache、激活、框架缓冲和系统余量。把 25.15 GiB 与机器标称内存直接相减,很容易高估可用空间。
用脚本复核单位
示例只做数学估算,不下载权重,不检查当前设备,也不执行推理。截图里的数值应与上面的理论值一致。
在系列目录下运行,需 Python 3.10+:
1 | python3 examples/lab_v2.py 09 |
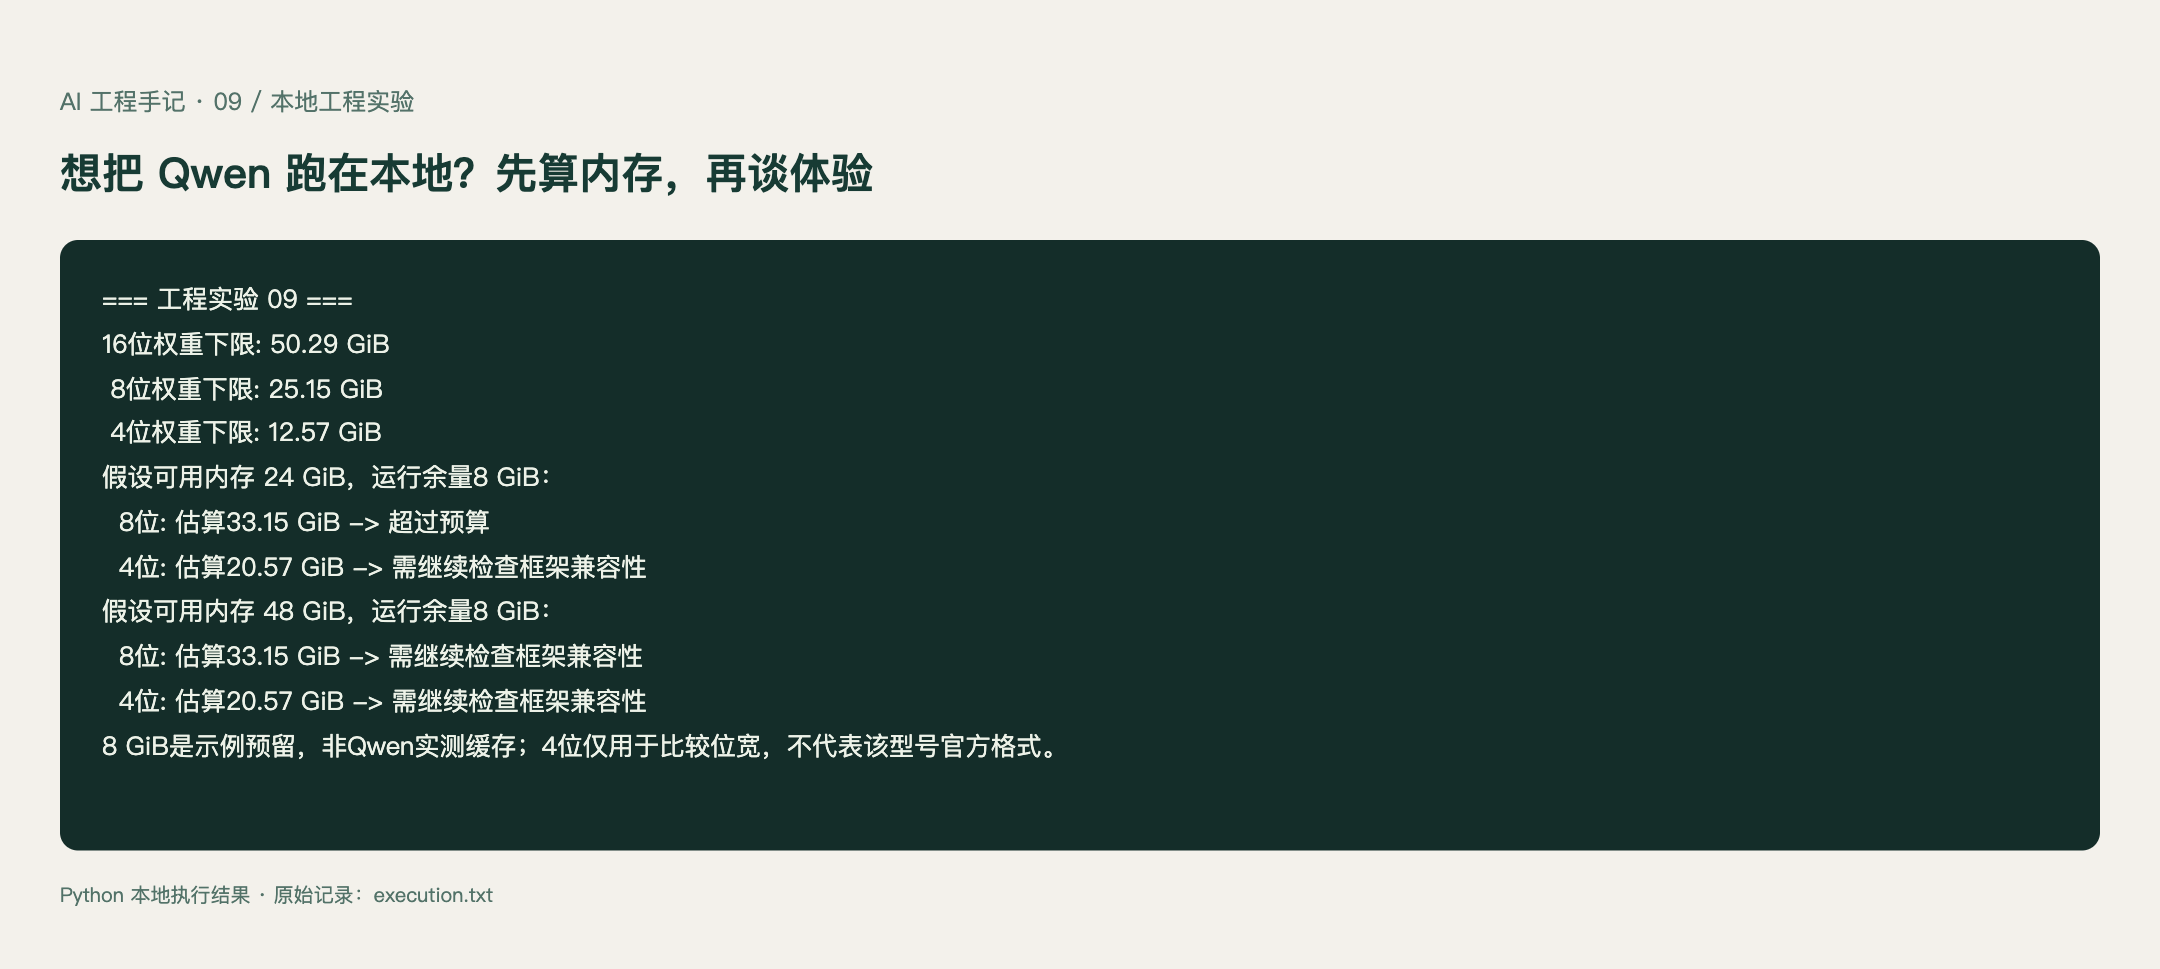
本地执行记录。完整代码:lab_v2.py,代码见文末。
1 | params = 27_000_000_000 |
这里比较 16、8、4 位,并不意味着该型号官方提供了全部对应量化文件。具体格式、精度变化、算子支持和硬件兼容性,需要核对实际模型卡与推理框架。
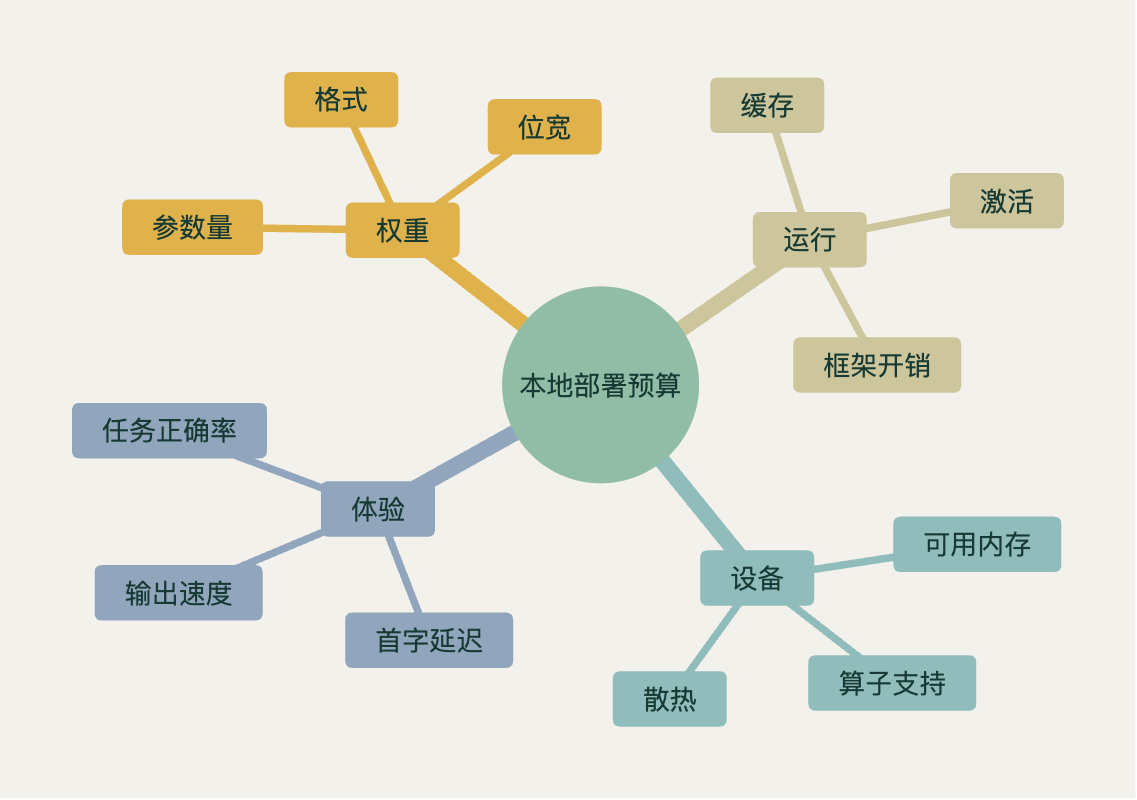
容量够了,还有三件事
第一是格式。FP8、GGUF、MLX 等不是随便改扩展名就能互换的文件;框架需要支持对应架构和量化方式。
第二是上下文。窗口设得越大,通常越需要额外缓存与处理资源;具体开销与模型架构有关,不能只套一个通用常数。建议从较短输入、单并发开始观察实际内存,再逐步增加。
第三是体验。首 token 延迟、输出速度、任务正确率与持续运行稳定性,都比“能启动”更接近真实使用价值。CPU 卸载可能让模型装得下,也可能把交互速度拉低。
| 阶段 | 记录内容 | 不应直接推出的结论 |
|---|---|---|
| 算权重 | 位宽与字节单位 | 机器一定能运行 |
| 启动服务 | 框架版本与峰值内存 | 长上下文也稳定 |
| 跑小样本 | 延迟与输出 | 所有任务都好用 |
| 持续任务 | 温度、并发、失败记录 | 换机器还能复现 |
怎样完成真正的部署验证
选定模型文件和框架版本后,先按官方模型卡启动最小服务,确认请求确实发往本地地址。保存启动参数、设备信息和一组固定输入;再测不同输入长度下的峰值内存与延迟。
涉及隐私时,还要检查客户端有没有调用云端补全、搜索或遥测接口。“权重在本地”只描述模型文件的位置,不自动代表整条工作流离线。
同样是 27B,文件能装下只是第一关
参数量乘位宽,算出来的是权重本体的理论下限。它适合判断量级,不适合直接当设备购买清单。
例如 8 位权重大约 25.15 GiB。如果机器可用内存只有 24 GiB,连这个下限都装不下;如果可用 48 GiB,也只是多了一些余量,后面还有运行时与缓存的账要算。
这次脚本把 24 GiB 和 48 GiB 当作两种假设预算,再统一预留 8 GiB 做比较。这 8 GiB 只是教学预留,不是测得的 Qwen 缓存需求;它的作用是提醒自己,不要把全部可用空间都分给权重。
1 | weight_gib = params * bits / 8 / (1024 ** 3) |
同理,4 位在公式上更小,也不代表当前 FP8 文件可以直接用 4 位模式运行。你还得找到对应格式、转换方案和支持它的推理引擎。
按这个顺序排查,会少下载很多次
第一步,确定具体模型文件。完整名称、量化方式、修订版本都记下来,不要只写“Qwen 27B”。
第二步,查引擎是否支持这一架构和格式。框架同样需要版本,不能把一个较新的模型卡命令直接放进旧环境里碰运气。
第三步,选最小可运行配置。先短输入、单并发,观察是否能稳定完成一次生成;确认这条链路后,再逐步增加输入和并发。
第四步,保存实际设备信息、启动参数与用量记录。某次成功的配置留下来,下次更新模型或框架时才有东西可比。
本地模型的验收,要回到自己的任务
| 工作任务 | 我会固定的输入 | 主要检查 |
|---|---|---|
| 代码辅助 | 同一份小型修改需求 | 能否运行、是否改坏原有行为 |
| 资料整理 | 同一组带噪声文档 | 是否漏掉约束、能否找回来源 |
| 结构化提取 | 同一组字段样本 | 字段类型与业务值 |
| 图片理解 | 同一组自有截图 | 数字、对象和文字是否识别正确 |
开始时不必收集上百个榜单题。选几项你每周真会做的事情,记录首字延迟、完成时间和返工情况,往往更容易判断这套配置有没有用。
如果把部分计算卸载到 CPU 后终于能启动,也不要就此宣布部署成功。继续看看一次正常任务要等多久、机器持续运行是否稳定,以及你是否愿意日常使用它。
做一次自己的容量阶梯测试
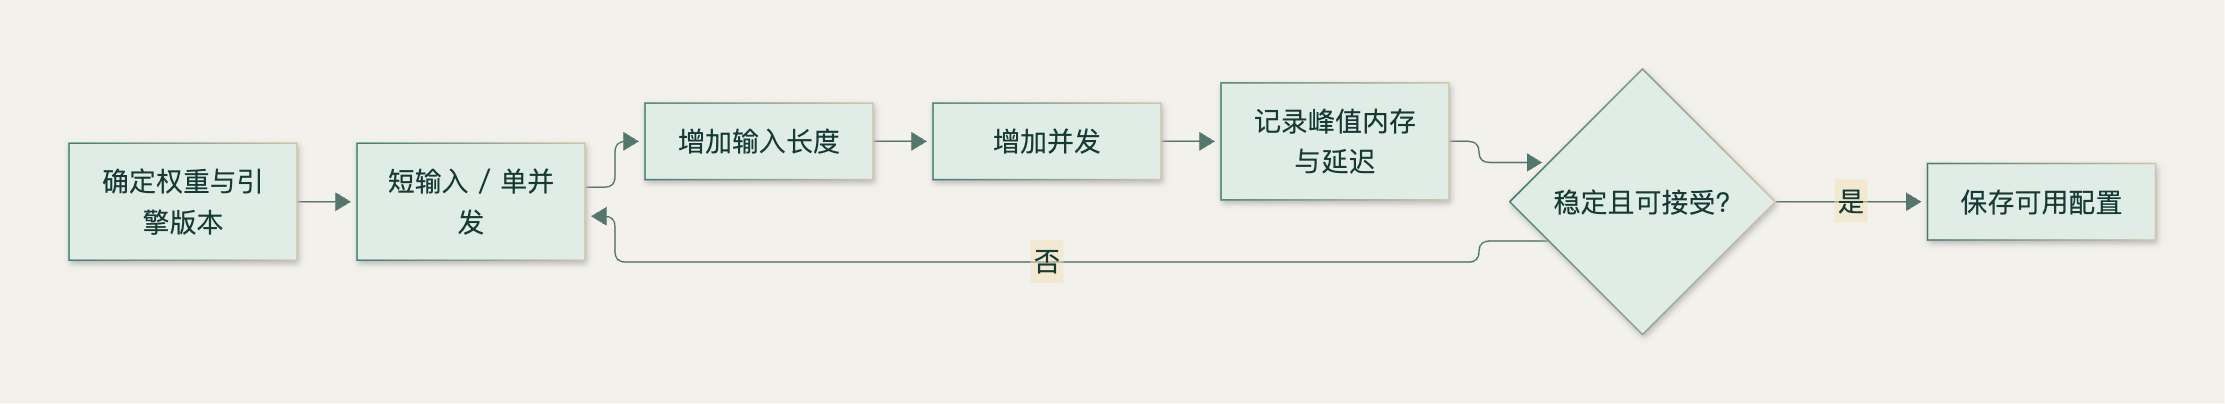
启动成功以后,我会逐步增加输入长度,而不是立刻打开最大上下文。每一级固定同一段任务说明,记录峰值内存、首字延迟和完成状态。
1 | 第一级:短输入,单并发,确认基本输出。 |
它的目的不是得到一个能对外宣传的速度数字,而是找到这台机器适合的工作区间。输出长度、图像输入和后台程序都会影响结果,因此设备环境也要一起记。
如果某一级突然变慢,先看是否发生内存交换或 CPU 卸载,再决定缩短输入、减小并发,还是换配置。不要只看进程还活着,就以为任务仍然能按日常节奏完成。
量化需要比较任务质量
位宽降低能减少权重空间,但实际质量变化要看量化方法和任务。不能从公式直接推出某个版本的回答和原版完全一致。
我会固定一小组含关键数字、代码修改与结构化提取的样本,在不同配置下保留原始输出。先看业务正确性,再看速度和容量收益。
尤其是你准备用它做自动执行时,能聊天不代表能稳定给工具参数。一个看似很小的数字错误,可能会直接影响后面的操作。因此模型的可用性要跟任务绑定,而不只看它是否回答流畅。
为更新保留一个能退回的配置
框架升级可能解决兼容,也可能改变默认参数。模型文件、启动脚本和依赖版本都保留下来,至少能恢复上一套已经验证的组合。
我倾向于给每个可用配置起一个简单标识,写清对应权重修订、引擎版本和任务样本。新配置先跑同样的检查,通过以后再替换日常服务。
如果只有一份不断修改的启动命令,某次更新失败以后,很容易连之前为什么能跑都记不清。保留这点配置记录,并不会增加多少负担,却能省掉很多重新排查的时间。
本地部署给了你更多选择,也把一部分维护工作交回自己。把这种维护成本算进去,才更容易决定它适合长期做什么。
把本地执行和整条链路分开检查
权重在本机,并不自动说明客户端所有能力都在本机。它可能另接搜索、远程转写或其他服务。需要离线处理的资料,就逐项检查请求目的地与工具配置。
这里无需把系统做得很复杂。先让最小链路清楚:请求发到哪个地址,哪段代码加载模型,结果写在哪里。需要增加外部能力时,再明确它拿到什么输入。
我看好本地模型带来的控制空间,也愿意为这种空间做一点配置工作。但配置的目标最终还是使用。等同一套任务能稳定跑下来、速度能接受、资料流向也清楚,再继续投入硬件,判断会更有依据。
完整实验代码
保存为 examples/lab_v2.py 后,使用前文命令运行。
展开完整 Python 示例
1 | import argparse,csv,hashlib,io,json,subprocess,tempfile |
延伸阅读
- Qwen3.8-27B-FP8 历史模型卡,2026-08-14。
- 数字生命卡兹克:Qwen3.8-Max 与 27B 版本的公开分享(存档),2026-08-03。
- QwenLM/Qwen3.5 同期提交,2026-08-17。