2026 年 4 月 29 日
DeepSeek V4 预览刚发布几天,各种题目、代码演示和价格讨论已经跟着涌了出来。碰上这种更新,最容易做的事就是换一个模型名,再问几道熟悉的问题。
试一试当然有必要。但如果你手上已经有一个需要每天交付结果的工具,还得回答一个更具体的问题:这次更新,能不能让自己的任务更稳、更省事?
4 月 24 日的官方预览公告给出了 V4 Pro 和 V4 Flash,并提供开放权重入口。发布公告 我会先把版本和业务任务一起固定下来,再比较是否值得切换。
GitHub 社区对开源模型的投入,也体现在推理基础设施上。DeepSeek 的 FlashMLA 仓库在这一阶段已有持续提交。同期仓库 它提醒我,模型权重、推理框架与业务结果是不同层面的事情:基础设施值得关注,但具体任务还是要自己验收。
卡兹克 4 月 27 日的 V4 体验,把讨论放在国产部署与实际使用场景里展开。相关观点 我更想沿着这个角度往下做:先把模型放进一条真实工作链路,再看失败发生在哪里,而不是把所有题型揉成一个印象分。
下面拿结构化账单输出做例子,搭一层最便宜也最容易漏掉的回归检查。
先评业务契约,再看排行榜
假设系统要求返回 id 和整数金额 amount。如果模型返回“金额约为两百元”,人能看懂,程序却无法可靠处理。如果返回 "200",JSON 虽然合法,类型仍然错了。
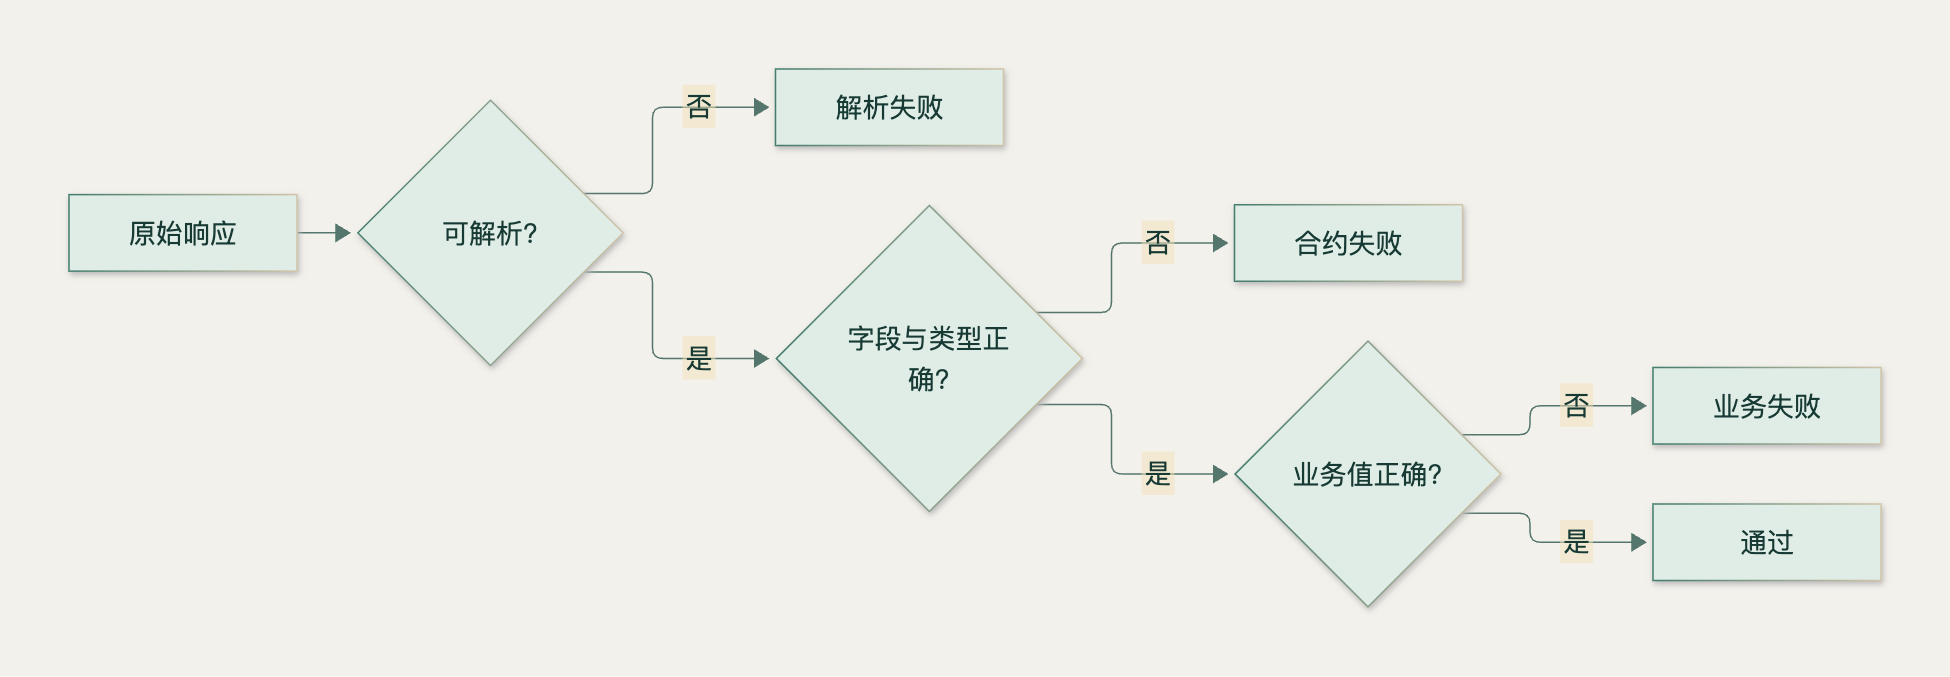
因此我会把检查分成四层:能否解析、字段是否正确、业务值是否正确、执行成本是否可接受。每层失败分别统计,不要混成一个笼统的“回答不好”。
先跑不需要 API 的检查器
本例构造五份人工响应,逐层检查解析、结构与业务值。它们用于验证检查器能否发现已知错误。
在系列目录下运行,需 Python 3.10+:
1 | python3 examples/lab_v2.py 08 |
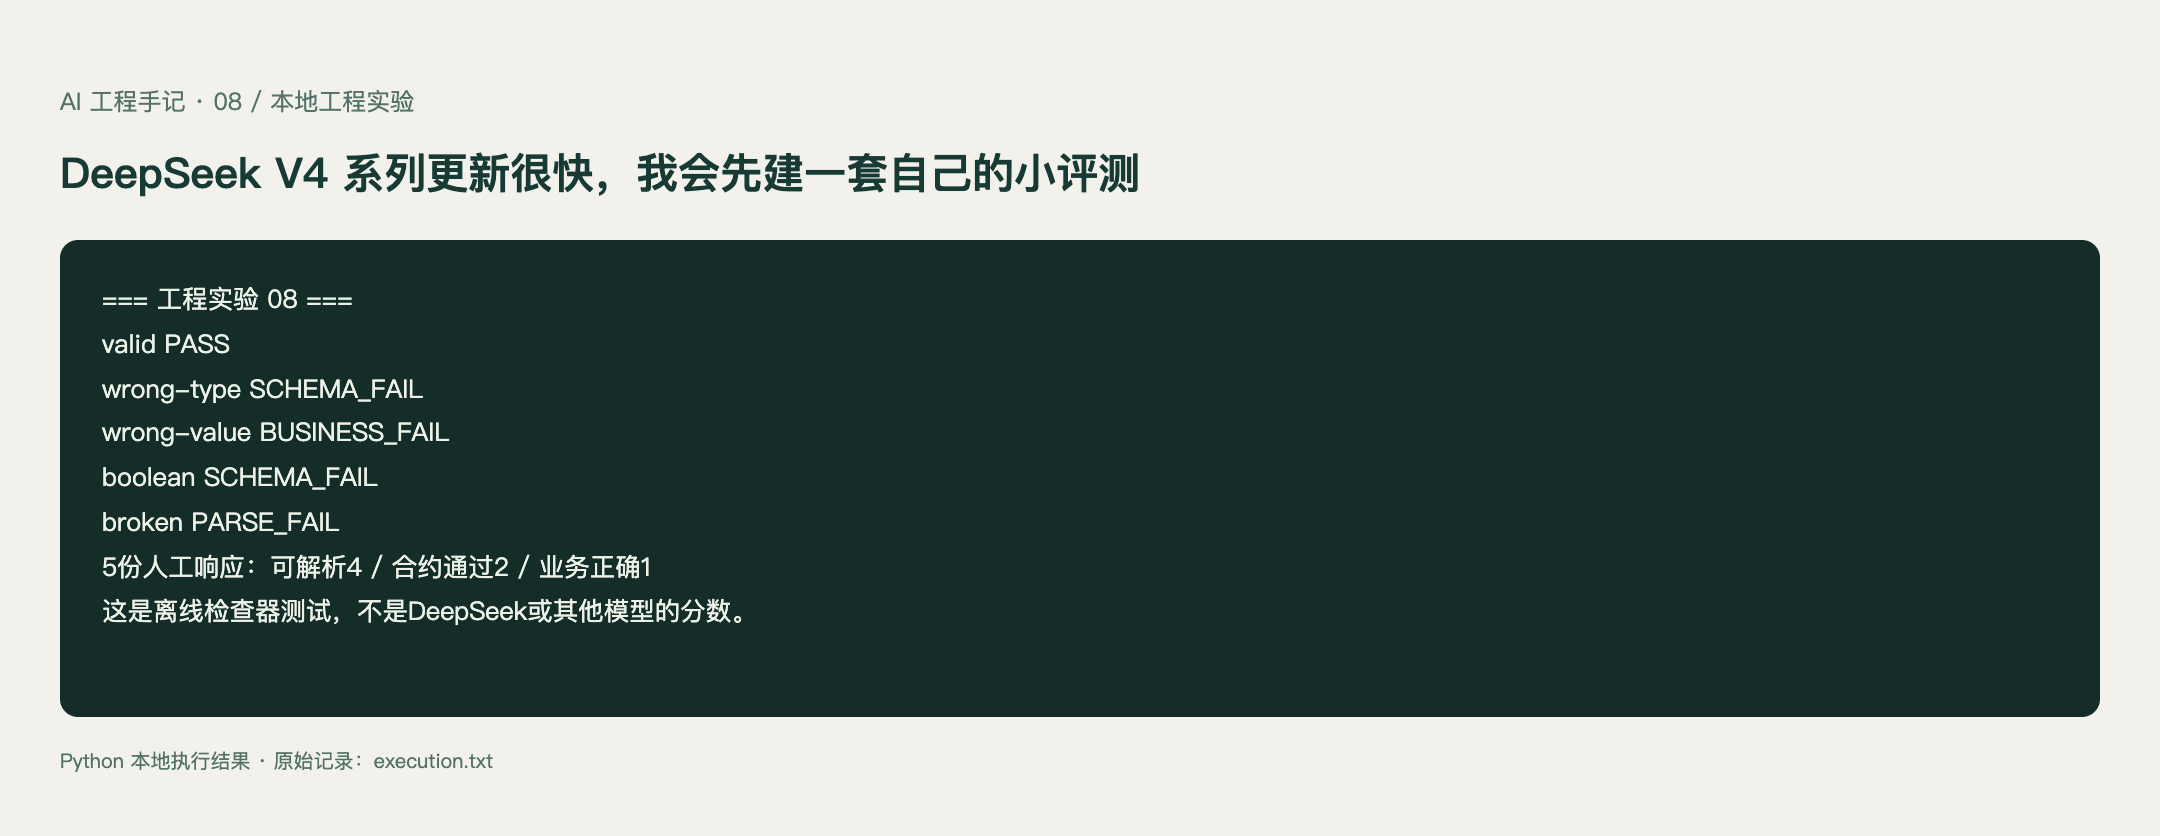
本地执行记录。完整代码:lab_v2.py,代码见文末。
检查整数时有个 Python 小细节:bool 是 int 的子类。若业务不接受 true 作为金额,使用 type(value) is int 比只用 isinstance(value, int) 更严格。本例采用前者。
1 | ok = ( |
如果业务要求禁止额外字段,还应校验键集合;如果允许负数或空值,也要明确规定。检查器本身就是业务契约的一部分,需要版本控制。
然后才接真实模型
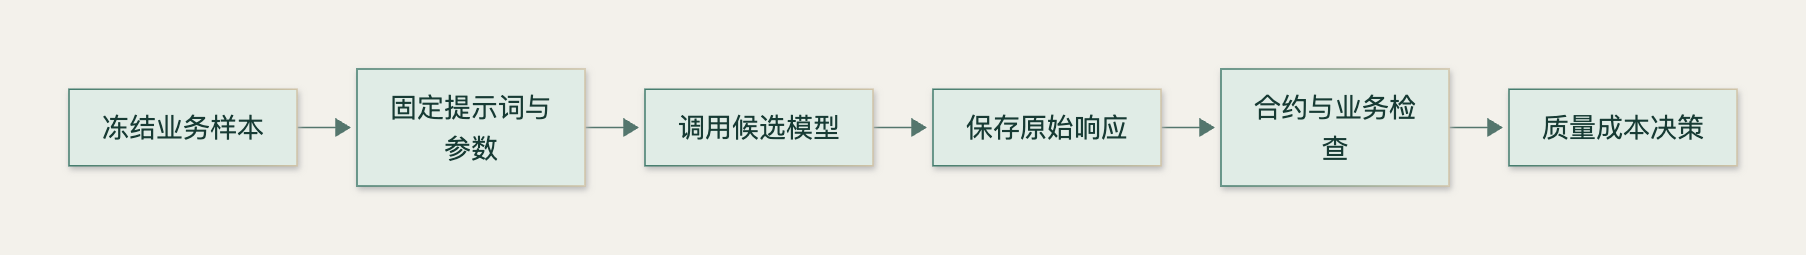
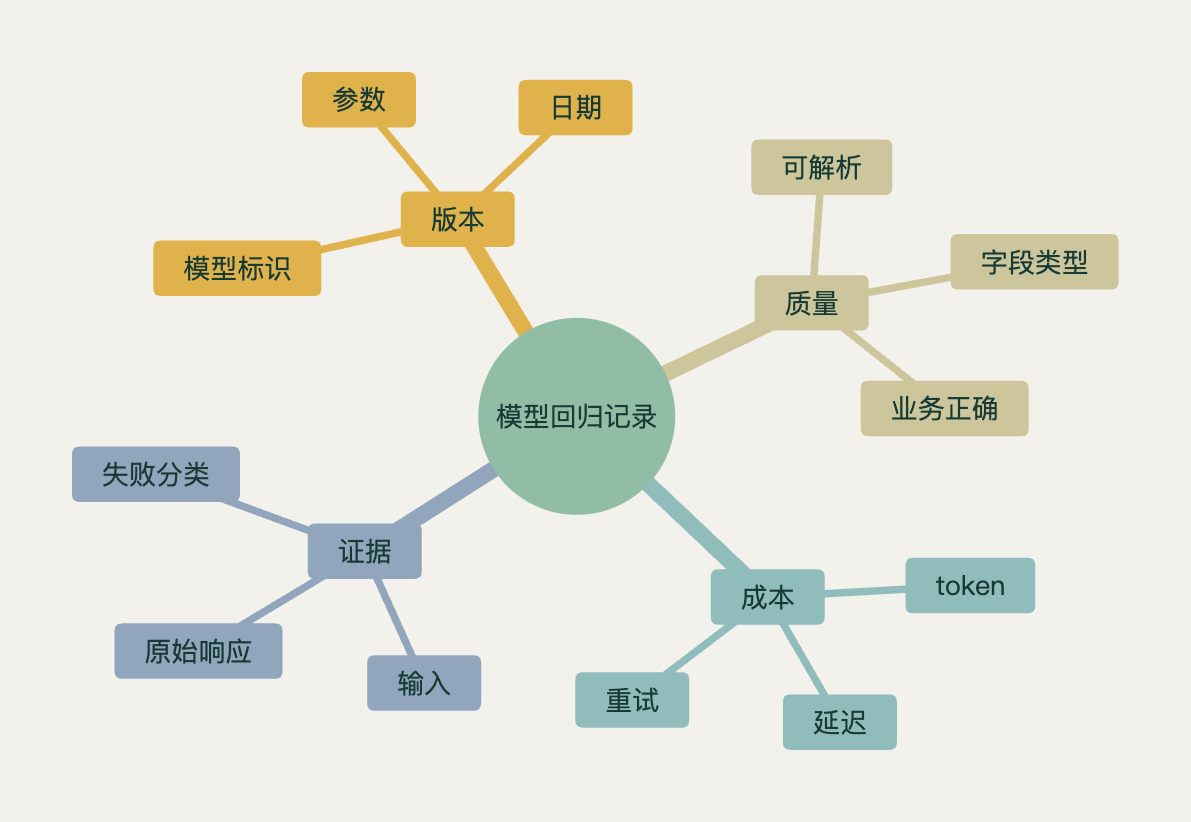
准备一组脱敏样本,冻结提示词、预期输出和评分规则。记录模型的实际标识、调用日期、采样参数、返回原文、token 用量、延迟和费用。别只记一个会随时间更新的别名。
| 样本类型 | 想检查的行为 |
|---|---|
| 正常输入 | 字段正确、金额正确 |
| 缺少金额 | 明确报缺失,不编造 |
| 重复单号 | 按规则处理冲突 |
| 噪声和错字 | 不误读关键数字 |
| 不相关请求 | 不输出看似合法的虚假账单 |
小样本适合挡住明显回归,不能据此宣称模型全面领先。涉及高频业务时,还应看不同输入类别的失败率,而不是让大量简单题淹没少量关键失败。
换模型之前,我想看到这份记录
一次升级报告最好说明:旧版本和新版本分别通过多少、失败样本有没有变化、成本是否下降、是否存在需要人工确认的行为。需要重试才能成功的任务,重试成本也要算进去。
真实模型响应接进来之后,才开始比较模型表现;先用错误样本检查评分器是否可靠。
一份看起来正常的 JSON,可能错在三个地方
设定任务要求返回:
1 | {"id": "A001", "amount": 100} |
接着看三个回答:not-json、金额为字符串的 JSON,以及金额是 999 的 JSON。第一份无法解析,第二份类型不符,第三份格式完全正确,业务值却错了。
如果你只统计“能返回 JSON 的比例”,后两种失败都会被掩盖。接入程序可能照样运行,直到总额对不上,才发现问题已经往下游传了。
所以我会拆开统计:解析、结构、业务值。每一层失败分别保留输入和原始响应,便于回头调整提示词、约束或模型选择。
先证明检查器能抓错,再让它评模型
这次实验用五份人工响应,覆盖合法结果、类型错误、业务值错误、布尔值和无法解析的文本。预期结果是 4 份可解析、2 份结构正确、1 份业务正确。
为什么放一个布尔值?因为 Python 中 bool 是 int 的子类。如果金额校验只写 isinstance(value, int),true 就可能溜过去。这里使用 type(value) is int 明确排除它。
1 | schema_ok = ( |
这些输入用来测试评分器,不代表任何模型的表现。先确认它能拒绝已知错误,再接真实响应,测试结果才有解释空间。
一组十来条样本,也要覆盖难点
| 类别 | 样本怎么准备 | 重点观察 |
|---|---|---|
| 正常单据 | 字段完整、金额清楚 | 基础正确性 |
| 信息缺失 | 不提供金额或编号 | 是否主动指出缺失 |
| 相似冲突 | 同号不同金额 | 是否按业务规则分流 |
| 噪声输入 | 混入旧记录和说明文字 | 是否提取错对象 |
| 越界任务 | 请求推测不存在的信息 | 是否编造可用结果 |
数量少并不可怕,怕的是十条全是简单输入。一个每天只出现一次、却会影响结算的失败,比十份漂亮的正常回答更值得先解决。
成本要算到一次真正通过为止
只比较单次请求价格,会漏掉重试和人工返工。某个模型调用一次便宜,但要改提示词再问三次,最后还得手工修金额,整体成本未必更低。
我会记录每项任务的调用次数、实际用量、完成延迟和人工修正时间。失败也保留,不能只导出最后成功的那份响应。
这份记录还应该包含实际模型标识和调用日期。若服务端别名发生变化,至少能知道两次实验是否确实比较了相同对象。采样参数、工具和提示词也尽量固定,避免一次修改了太多因素。
提示词、工具和样本,别一起换
一次模型切换,如果同时更新提示词、增加检索、改输出格式,就算结果改善,也很难知道是谁起了作用。
我会先固定任务链路,只换模型;再根据具体失败调整一个环节。保留每次变化,这样能分清模型能力变化和工程配置变化。
1 | run-01:模型 A,提示词 p1,检查器 v1。 |
这不是为了做复杂研究,而是为了让一次上线决定有依据。否则半年后回头看,只有“当时感觉更好”这句话,很难知道该怎么恢复或继续优化。
不同失败,需要不同的修法
无法解析时,可以检查结构化输出方式或增加严格格式约束;字段类型错时,检查字段说明和示例;业务值错时,回到原始资料与推理步骤,看看是不是提取了错误对象。
如果输入本身缺信息,就不应该靠增加重试次数解决。模型反复生成一个完整答案,只可能把猜测包装得更像真的。此时正确行为是报告缺失,或者返回可以继续处理的部分。
对同一任务,重试策略也应保持一致。A 模型只问一次、B 模型允许问三次,最后比较成功率,很难看清实际成本差异。
把人工修改也变成可分析的记录
检查器可以抓住明确规则,但仍有一部分质量需要人判断。比如摘要有没有遗漏重要背景,方案是否真的适合当前项目。
我会给人工意见分几个简单类别:事实错误、关键遗漏、表达问题、格式问题、任务理解偏差。每次只留一个模糊的“质量不行”,后面就不知道该改模型、改资料,还是改需求描述。
涉及上线时,先选一小部分能回退的任务试用。观察失败分布是否与离线样本接近,再决定扩大。若出现新类型的失败,就把它补进样本集,而不是仅在当天手工修完。
这样评测会跟着业务积累。它不需要一开始很大,但应该越来越能代表你实际交给模型的工作。
让升级决定有一个可以复查的依据
第一次比较不用急着给出“全面胜出”的结论。更有用的报告可能是:普通账单表现接近,缺失字段处理改善了,冲突识别仍需人工检查,所以先迁移低风险任务。
这样下次继续更新时,你还有一份基线可以比。知道哪里改善,也知道哪些地方不能因为新版本来了就取消检查。
我期待更强、更便宜的模型,但希望升级带来的是可重复的收益。先让检查器能发现错误,再让真实任务告诉你是否该换,这套顺序值得一直保留。
完整实验代码
保存为 examples/lab_v2.py 后,使用前文命令运行。
展开完整 Python 示例
1 | import argparse,csv,hashlib,io,json,subprocess,tempfile |
延伸阅读
- DeepSeek V4 Preview 公告,2026-04-24。
- 数字生命卡兹克:为国产化而生,DeepSeek V4 体验(转载),2026-04-27。
- deepseek-ai/FlashMLA 同期提交,2026-04-29。
- 博主原文的同期日期另见优设 4 月收录记录,只概括其中与本文相关的使用观点。