2026 年 3 月 16 日
模型上下文变大之后,最直接的诱惑就是:资料都放进去,省得来回找。
项目文件、需求讨论、运行日志、昨天的方案一起塞进去,确实方便。可等同一个接口先后改过三版,旧方案又写得特别完整,问题就来了:模型现在应该相信哪一份?
3 月 13 日,Claude 官方宣布 Opus 4.6 和 Sonnet 4.6 的 1M 上下文正式可用。产品公告 我期待它能减少大型任务的拆分负担,但还不会因此放弃资料整理。窗口解决容量,材料的相关性和版本关系还得另外处理。
在 GitHub 上,Claude Code 的同期仓库保留着连续更新的变更日志。同期版本 对长任务工具而言,上下文处理显然需要跟工作流一起演进;读取什么、留下什么,都会影响后面的动作。
宝玉在二月初的技巧解读里,也提醒项目规则文件应保留最重要的信息,其他材料按需读取。相关观点 我更愿意把它理解成一个工作习惯:先确保目标和约束不会丢,再补当前任务真正需要的证据。
下面从一个重复计费问题开始,看看怎么给上下文排优先级。
先区分四种材料
目标告诉 Agent 要完成什么;约束告诉它哪些行为不能改变;证据告诉它当前问题在哪里;历史记录只是帮助追溯。它们的重要性不应该由“谁刚刚出现在聊天里”决定。
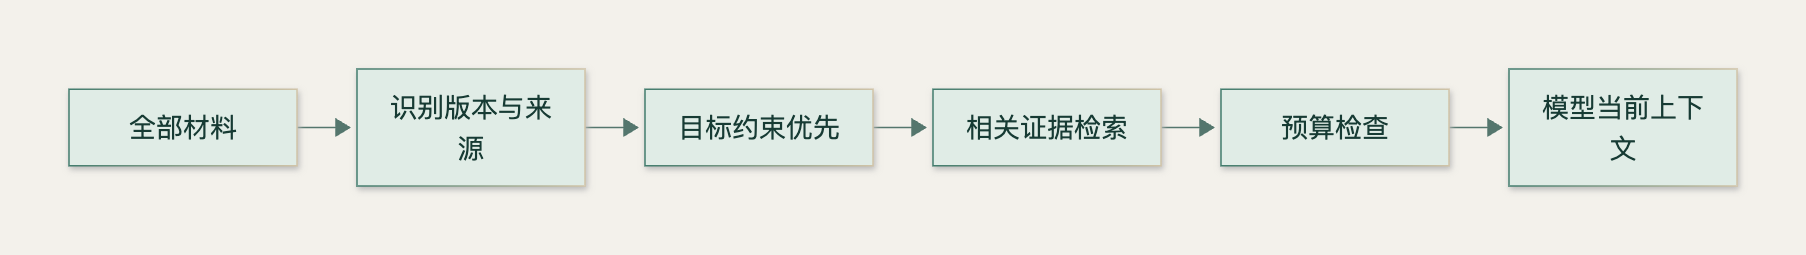
我会把当前目标、接口契约、未解决问题和下一步检查命令单独落盘。需要时重新读取,比指望一段长聊天永远被准确记住更可控。
做一次小规模装载实验
示例包含目标、字段规则、失败证据和旧日志。目标与规则标为必须材料;在 120 个 Unicode 字符预算下留下三项关键信息,在 10 字符预算下明确拒绝继续装载。
在系列目录下运行,需 Python 3.10+:
1 | python3 examples/lab_v2.py 06 |
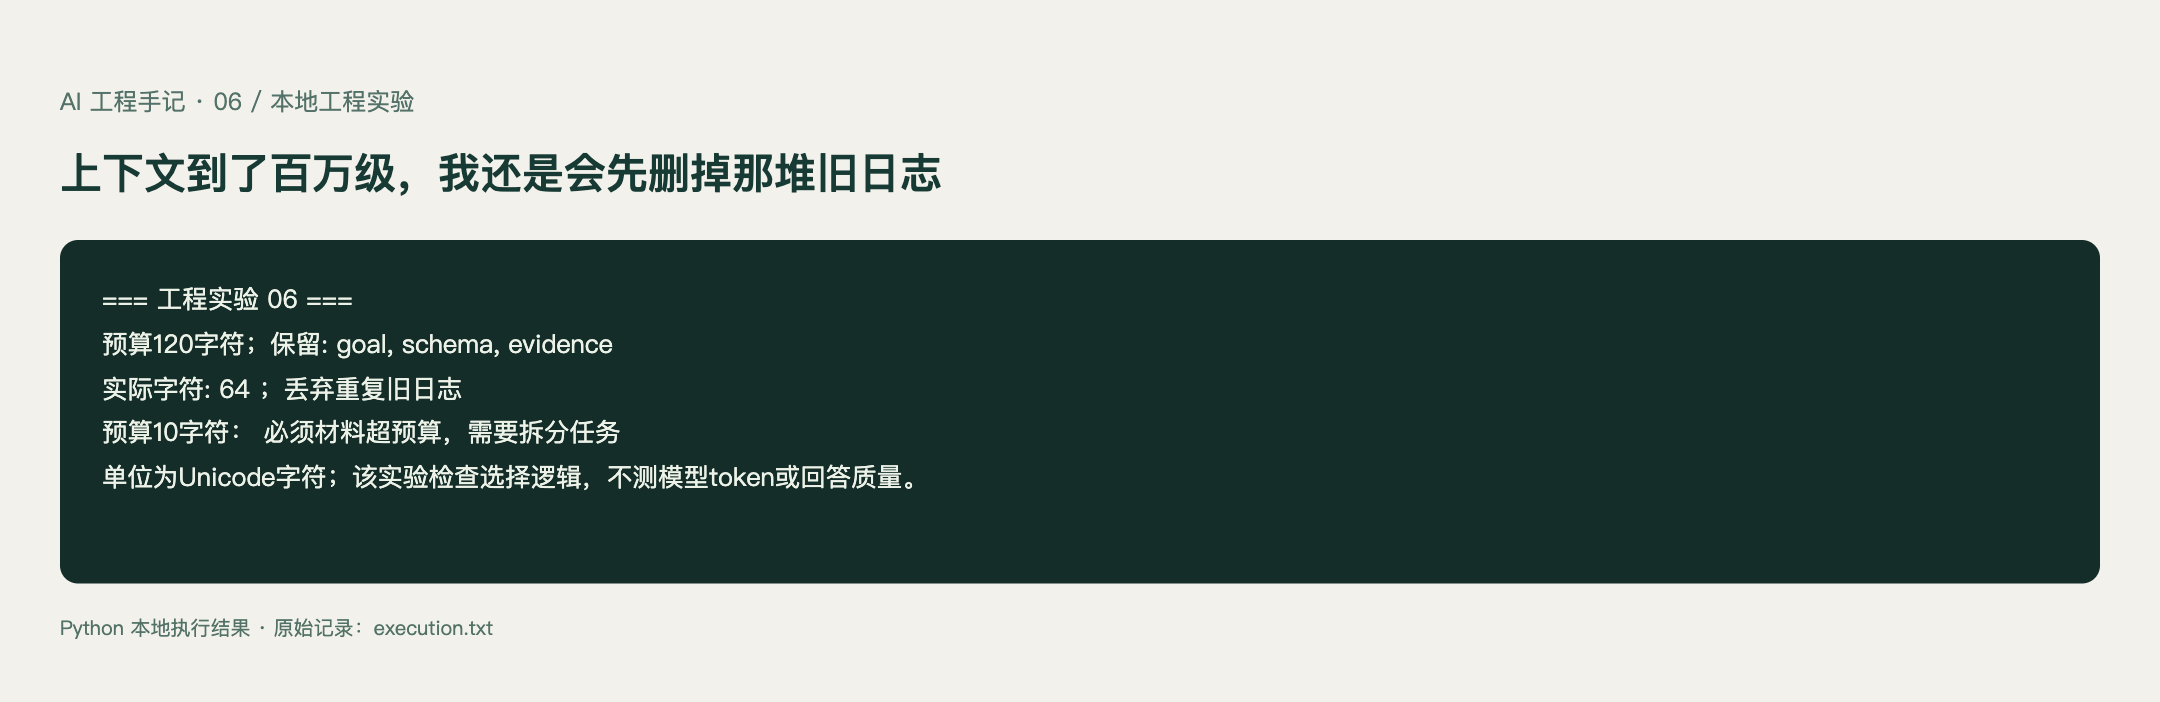
本地执行记录。完整代码:lab_v2.py,代码见文末。
核心先检查必须材料,再为剩余材料排序。下面是可选材料的装载思路:
1 | for doc in sorted((d for d in docs if not d["required"]), key=lambda x: x["priority"], reverse=True): |
这里用字符方便观察,字符数不等于 token 数。这个贪心算法也不是最优检索方案:长文档可能被整份丢弃,相互依赖的证据可能被拆开。真实应用可以先分块,再按任务相关度检索,并给来源、版本和时间打标签。
大窗口、检索、记忆不是一回事
| 方法 | 解决的问题 | 仍要检查什么 |
|---|---|---|
| 扩大窗口 | 一次容纳更多材料 | 成本、延迟、实际检索表现 |
| 按需检索 | 找到当前相关片段 | 召回遗漏、版本冲突 |
| 摘要压缩 | 缩短历史记录 | 约束和细节是否丢失 |
| 结构化记忆 | 维护可持续任务状态 | 过期状态、来源可追溯性 |
比如跨文件重构,完整相关文件可能比孤立片段更好;而排查某个错误码,先定位调用链通常比加载整个仓库更高效。策略应该跟着任务走,不能把“删得越多越好”当成另一条教条。
任务记忆应该存什么
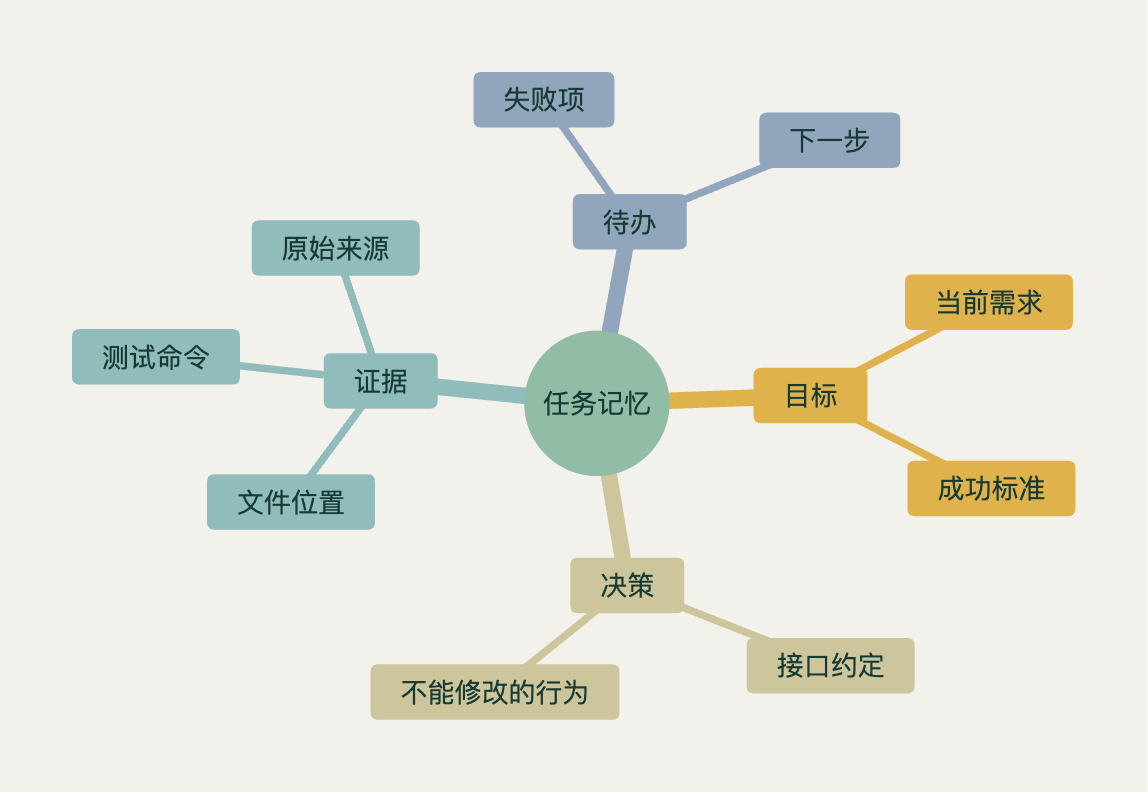
我倾向于维护四项:目标、已确认决策、未完成问题、验证证据。每条结论最好带文件位置或来源链接;“接口已经修好了”不如“提交 X 中修改了接口,命令 Y 已通过”可检查。
压缩前后可以做一个简单验收:让模型分别回答同一组关键问题,比如不可修改的字段是什么、尚未通过的测试有哪些。如果压缩后连这些都答错,摘要再短也没有意义。
本实验只验证材料选择机制,没有测任何模型的正确率或 token 消耗。要声称上下文优化有效,还需要固定任务集,比较答案质量、费用和失败类型。
日志越长,越要先问这次在解决什么
假设订单系统重复收到同一个事件,导致多次计费。你手上有四份材料:当前目标、最新字段约定、失败样本,以及一大段旧调试日志。
如果只按文件大小或最近访问时间装载,最重要的约束不一定能留下来。比如“不能改变计费规则”只有十几个字,却可能比几千行日志更关键。
我会给材料加上最小元数据:
1 | { |
required 保证本轮任务离不开的约束先进入上下文,version 帮助发现旧规则,优先级只用于剩余材料的取舍。对这个例子而言,目标和字段约定必须保留,旧日志可以按需再查。
必须材料装不下,就别悄悄删掉
一个容易写出来、也容易出错的算法是:按分数排序,放得下就加,放不下就跳过。这样可能得到一份看起来很精简的上下文,却把最重要的限制丢了。
这次实验多加了一道检查:先放入所有必须材料,预算不足就明确失败,要求拆任务。
1 | chosen = [doc for doc in docs if doc['required']] |
120 个字符的预算能留下目标、字段和证据;缩到 10 个字符时,脚本直接提示必须材料超预算。它没有为了继续执行而自行牺牲业务约束。
这里用字符数方便检查,真正接模型时要用对应 tokenizer 计算 token,并为输出和工具响应留出余量。这个预算模型的价值在于先把取舍规则做明确,而不是给出一个通用压缩比例。
摘要最好记录结论的位置
“接口已经改好了”很容易写,也很难接着工作。更有用的状态记录是:改了哪个文件、依据哪条约定、通过了什么检查、还有哪项未完成。
1 | 目标:相同事件只计费一次。 |
压缩时不需要保留每一次思考,但应保留能恢复工作现场的东西。否则下一轮 Agent 会重新猜需求,甚至把早就否定的方案再做一遍。
检索材料时,别把版本冲突藏起来
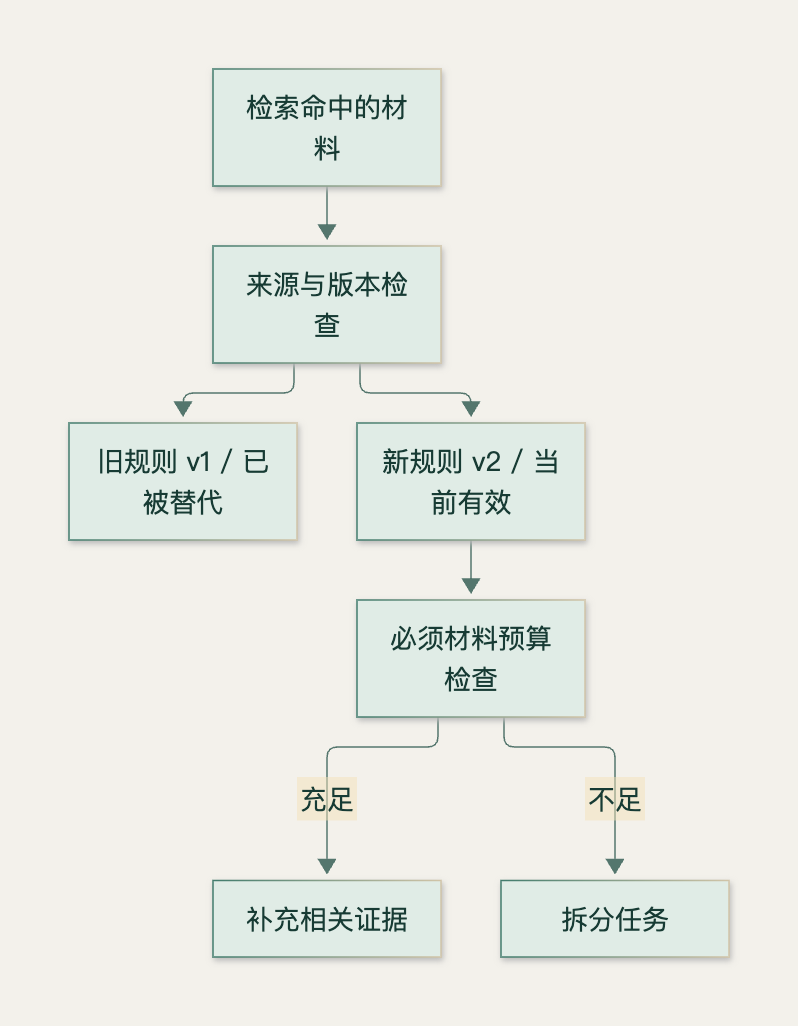
假设旧需求写着“重复订单按订单号去重”,新约定改成“按事件号去重”。两段文字都和当前问题高度相关,单靠相似度排序可能会一起命中。
这时不能只取排在前面的那个。至少要让材料携带版本、适用范围和替代关系,明确新约定覆盖了哪一条旧规则。
1 | schema-v1:按 order_id 去重,已被替代。 |
对模型而言,这比在一段很长的聊天里自行猜哪句话更晚、更权威简单得多。对维护者而言,也能解释为什么这次检索不再采用旧材料。
如果无法判断哪份有效,就把冲突暴露出来,请人确认。悄悄选一个,可能让后续所有代码都建立在错误前提上。
工具返回的长文本,也值得先整理
上下文膨胀经常来自工具输出:一条查询带回几千行日志,真正有用的只有其中几行。全部保留,下一轮仍然要在噪声里找线索。
我会先用确定性工具过滤时间范围、错误码和相关对象,再把筛选依据与少量结果交给模型。需要进一步追查时,保留原始记录的位置,允许它回去读取。
不过过滤不能把异常周围的因果信息一起删掉。比如只保留最后一行报错,可能看不到前面一次重试才是触发原因。因此要根据任务留出上下文片段,而不是机械截取固定字数。
让任务续接从状态文件开始
长期任务可以保留一个小状态文件,包含目标、已完成项目、当前阻塞和下一条验证命令。下一次会话先读它,再按链接回到代码和证据。
状态文件也需要更新时机。一次修改还没通过检查,就别提前写成完成;某个假设被推翻,就同步标为无效。否则越往后续接,越容易把一条旧猜测当作已经确认的事实。
我会把状态摘要看成导航,而不是完整档案。它负责告诉执行者下一步该去哪里找,原始文件和结果记录仍然保留。这样既能控制当前输入规模,也不必把历史全部扔掉。
给上下文也准备一组回归问题
我会选几个不该答错的问题:去重键是什么,金额单位是什么,哪些行为不能改变,尚未通过的测试有哪些。
每次调整检索或摘要方式后,用同样的问题核对。必要时再加一个“旧约定与新约定冲突”的样本,看它是否能指出冲突,而不是随手选一份。
这套检查不需要先做成复杂平台。把问题和预期答案保存在项目里,已经比靠“感觉它今天更懂了”稳妥。
大窗口可以让我们少做一些机械分块,但不能替我们决定什么仍然有效。我会把容量当余量,把版本、目标和证据当工作底座。资料变多时,下一步先改善读取方式,再决定继续增加多少输入。
完整实验代码
保存为 examples/lab_v2.py 后,使用前文命令运行。
展开完整 Python 示例
1 | import argparse,csv,hashlib,io,json,subprocess,tempfile |
延伸阅读
- Claude:1M context 正式可用公告,2026-03-13。
- 宝玉:Claude Code 团队的 10 个内部技巧,2026-02-03。
- anthropics/claude-code 同期提交,2026-03-14。