2026 年 1 月 23 日
把文件拖给 AI,让它整理好再交回来,这种体验比“生成一段建议”更容易让人上头。
因为日常办公最烦的那部分,常常不是想不明白,而是得在一堆文件之间来回搬东西。票据截图里有金额,会议记录里有待办,表格里又是另一套字段。你知道要交什么,却还得花时间把输入揉成同一种形状。
Cowork 在 1 月 12 日进入研究预览,Anthropic 次日的 Labs 公告提到了它。这个时间点值得关注:编程 Agent 的执行能力,开始用文件夹和自然语言任务的方式交到更多人手里。产品背景
一月的 GitHub 社区也能看到同类需求。开源桌面 Agent 项目 Eigent 已经在迭代;翻它 1 月 23 日的记录,可以看到修复空白页面、处理 Python 运行环境等具体工作。同期仓库 这类记录让我更关心上手之后的体验:程序启动了,用户能不能顺利把任务交进去,出问题时又能不能找出原因。
卡兹克在 1 月 22 日介绍 Skills 时,展示过把选题工作拆成采集、生成、审核几步的做法。相关观点 我觉得这个思路搬到文件任务里也很实用:复杂办公工作需要几个明确环节,不能只给一个笼统目标,再期待所有细节自动对齐。
如果今天就挑一件事试,我会选 CSV 对账。它看着普通,却能很快暴露文件自动化最重要的三个问题:输入有没有读对、规则有没有说清、异常有没有留下。
先定义“整理完”的含义
拿报销 CSV 举例,我会要求保留源文件、检查重复单号、输出去重金额,并列出无法判断的记录。只要这些条件写清楚,结果就有了检查方法。
输入目录建议分成 input/、output/、review/。其中 input/ 是逻辑上的只读区;真正防止覆盖,还需要操作系统权限或工具策略。给文件夹换个名字,本身不会产生权限隔离。
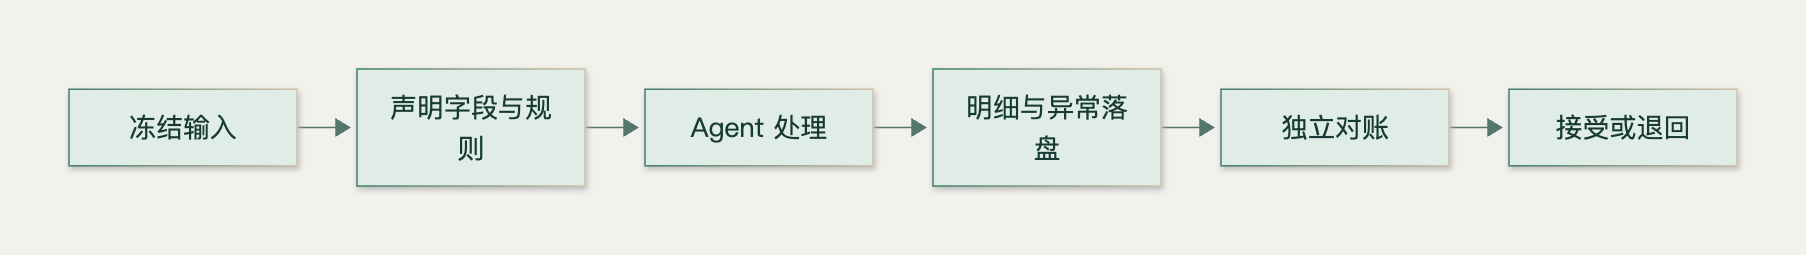
先在本地复现一次对账
实验准备了六行数据,包含一次同金额重复、一组金额冲突,以及一行坏数据。按“冲突与无效输入单列”的规则,可以确认的金额为 300 分。
在系列目录下运行,需 Python 3.10+:
1 | python3 examples/lab_v2.py 02 |
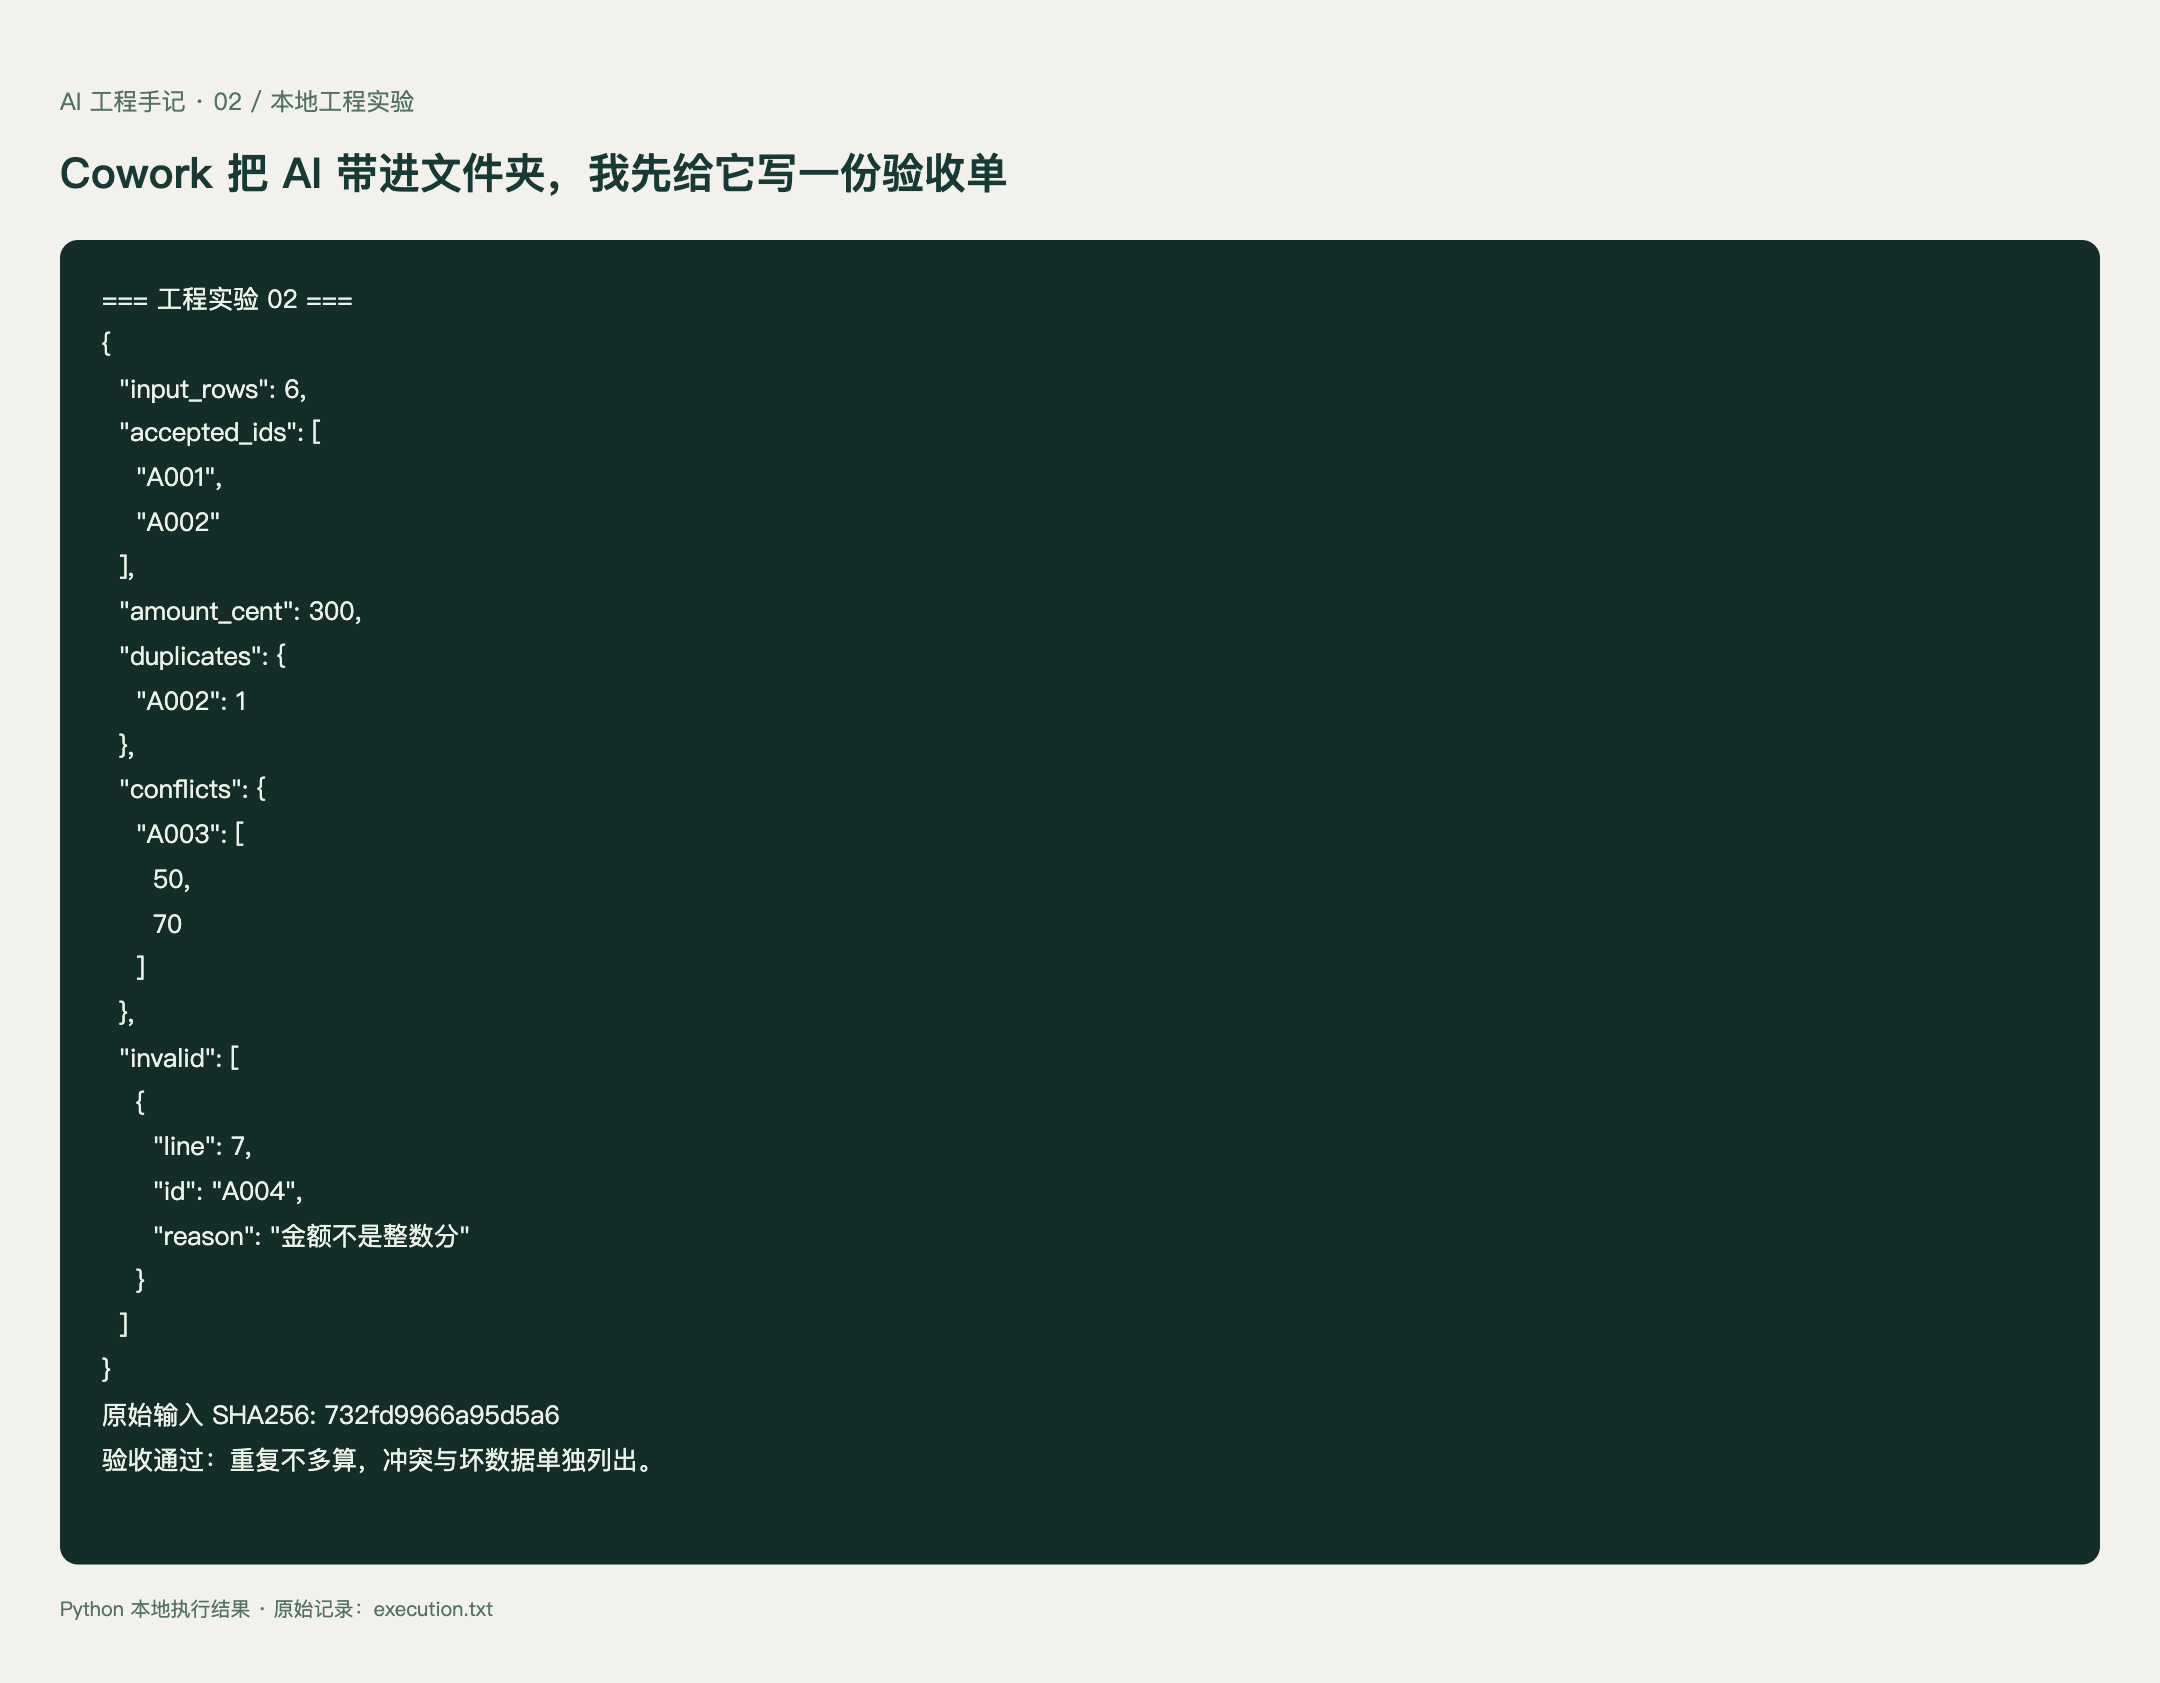
本地执行记录。完整代码:lab_v2.py,代码见文末。
相同单号出现不同金额时,先列为冲突,再决定怎么处理。 下面把规则和样本展开说清楚。
可以直接交给文件型 Agent 的任务描述如下:
1 | 读取 input/ 中的 CSV,不修改源文件。 |
别只看最后一行数字
| 检查对象 | 容易漏掉的情况 | 对应证据 |
|---|---|---|
| 输入 | Agent 读取了旧版本 | 文件哈希和文件名 |
| 规则 | 去重键选错 | 重复记录清单 |
| 金额 | 元、分混用 | 字段单位说明 |
| 输出 | 只汇总,没有异常 | 冲突与失败文件列表 |
本例额外输出源数据 SHA256 的前 16 位,用来帮助对应这次实验。严格审计时应保留完整哈希,并记录工具版本、规则版本和执行时间。哈希只能说明文件是否变化,不能证明文件内容本来就正确。
我会这样安排第一轮试用
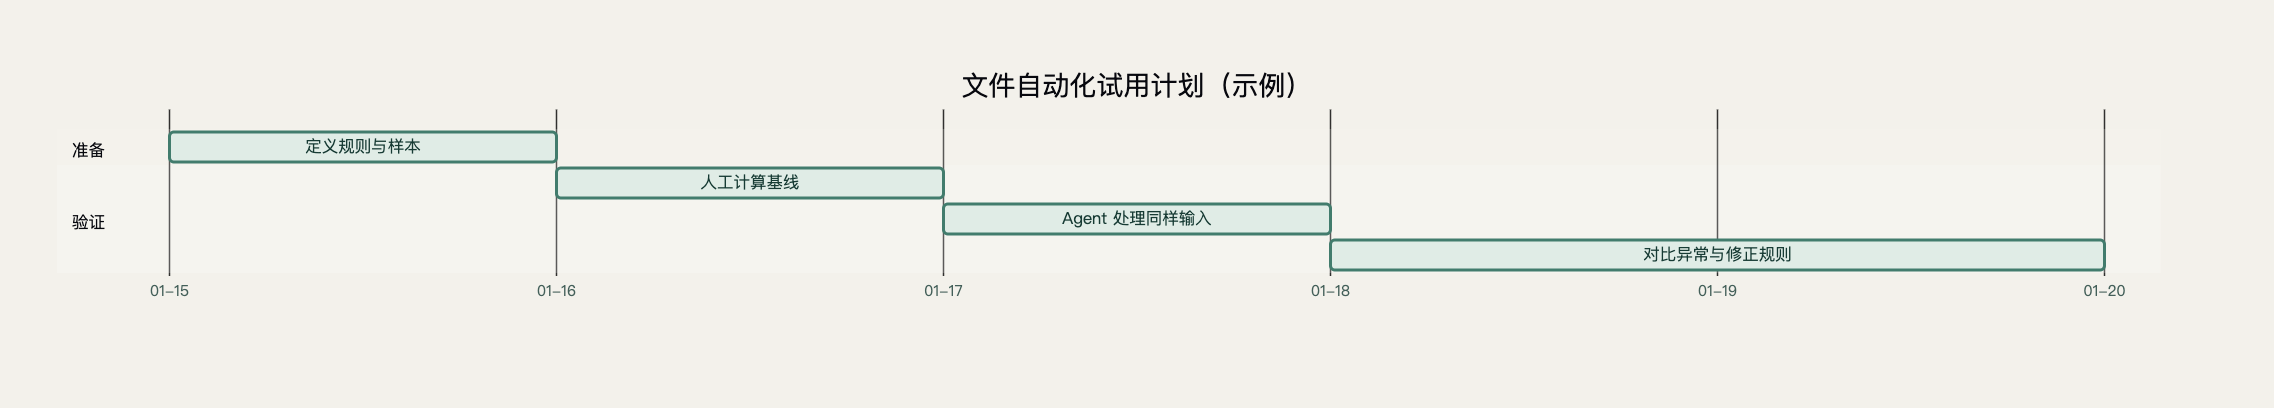
图里的日期是示例排期,不是产品发布时间。先手工跑通一份小样本,再让 Agent 处理同一份输入,把差异逐项列出。前两轮先别追求完全无人值守,先找出规则里没有说清楚的地方。
这段 Python 先把对账规则跑通。接进文件型 Agent 后,再检查它读到的文件和采用的规则是否一致。
真正难的,往往是两份都像真的数据
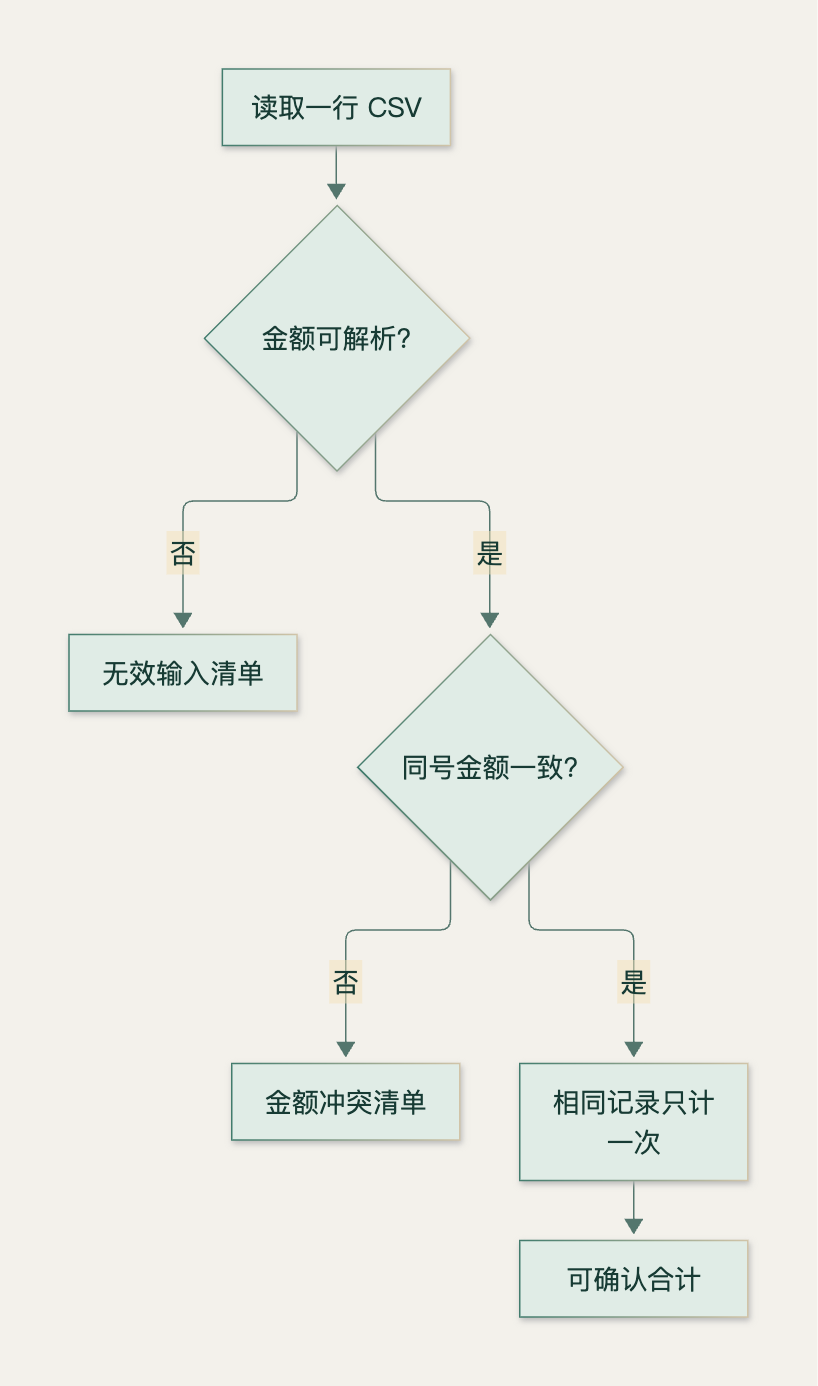
我们把例子再往前推一点。假设同一单号出现两次,而且金额不同,你会怎么处理?
1 | id,amount |
A002 两条记录金额一致,可以按约定视为重复;A003 的金额却对不上,不能随手选一条;A004 连金额都无法解析。把它们都交给“智能去重”,最后得到一个干净总额,看起来省事,实际上把业务决定藏进了整理过程。
我会把输出拆成三份:能确定的记录、需要确认的冲突、无法处理的输入。这里可以确认的是 A001 和 A002,总额为 300 分。A003 暂时不进入可确认合计,A004 保留原始行号等待修正。
这和“出错就整份文件失败”不一样。把有把握的部分先交出来,再明确告诉我哪些地方卡住,才方便继续工作。
1 | conflicts = {key: values for key, values in groups.items() |
一份验收单,比十句“仔细检查”更有用
我会把这次任务的验收单写成下面这样:
| 输入情况 | 期望结果 | 发现错误后怎么继续 |
|---|---|---|
| 同单号、同金额 | 只计一次,报告重复次数 | 可以继续汇总 |
| 同单号、不同金额 | 进入冲突清单,暂停计入 | 补充业务确认 |
| 金额格式错误 | 保留行号和原始值 | 修正后重跑 |
| 缺少必要字段 | 当前文件停止处理 | 明确指出缺哪个字段 |
这份表不长,却能把一次任务变成一套重复使用的规则。以后换文件、换 Agent,甚至换成普通脚本,都能用同一份验收标准。
当然,遇到“同一个人提交了两次但单号不同”的问题,就需要新的业务规则。单号查重不能顺便解决身份匹配。自动化越往真实场景走,越要把这些边界说清楚,而不是要求系统自行猜测。
把一个任务拆成可检查的中间产物
如果让 Agent 同时读几十张票据、识别金额、合并表格、写结论,最后只交一份报告,一旦总额不对,就得从头翻。更好的做法是把识别与计算分开,留下中间明细。
第一步,提取每张票据的文件名、单号、金额和无法确认的字段。第二步,把这些字段交给脚本统一校验。第三步,再让 Agent 根据已确认明细写摘要。语言模型负责理解资料,计算器负责把确定的数算完。
1 | input/ 原始文件 |
对图片识别出来的金额,我会保留它对应的源文件。否则模型把 100 看成 700,后面的计算再精确,也只是在认真处理一个错误输入。
遇到看不清的数字,最好让它交付一个待确认项,而不是用上下文补一个“合理金额”。办公自动化里有很多工作都适合这个原则:日期不明确就列出来,负责人不明确就待确认,别为了让报告完整而把未知填满。
一次完整的试用,应该怎么走
先手工算一份小样本,得到可确认总额;再运行脚本,检查分类是否一致;最后才让文件型 Agent 从原始资料开始完成同一任务。
这三轮比较能把错误分开。脚本结果不对,查规则和计算;脚本正确、Agent 提取错误,查识别和字段约束;明细正确、报告却写错,查摘要与格式生成。
有了这个顺序,就不需要一出错就重新写一大段提示词。每次只改一个环节,保留前后结果,也更容易知道修改有没有奏效。
第一轮试用我还会加一份空文件和一份缺字段的文件。系统应该说明它们为什么无法处理,其他文件是否继续,而不是把它们当成“金额为零”的正常记录混进去。
让下一轮修改能回到同一批输入
把原始输入、规则说明和结果放在一起,给它们一个批次名称。后续发现问题时,用同一批材料重跑,别同时换输入、换规则又换模型。
比如先修正冲突识别,再处理金额解析;如果两件事一起改,最终总额变对了,你仍然不知道错误是怎样被修好的。小样本并不意味着粗略,恰恰适合把变化看得更清楚。
跑通之后,再把输入规模逐步放大。每一步检查错误类型是否变化,比一开始就把整个共享盘交出去更容易积累经验。
文件交付也要考虑下一位接手的人
输出不要只叫 result.json 然后丢在下载目录里。至少要能对应到输入文件、规则版本和这次的异常清单。原始输入保留完整,新的结果写到另一处,方便随时回看。
源文件哈希很适合做这件事。它不能保证数据本来就正确,但能帮你确认:这次报告对应的,确实是同一份输入。
如果下一位同事打开目录,还得问你“这个数字怎么算出来的”,交付就还差一点。我希望自动化省掉的是搬运与重复计算的时间,也让接手的人少猜几次。
最后再决定要不要把这套流程接进 Cowork。先用固定样本把规则跑清楚,再交给 Agent 处理资料,验收时看它是否遵守了规则。工具界面可以变,业务上认定正确的结果应该保持稳定。
完整实验代码
保存为 examples/lab_v2.py 后,使用前文命令运行。
展开完整 Python 示例
1 | import argparse,csv,hashlib,io,json,subprocess,tempfile |
延伸阅读
- Introducing Labs,2026-01-13。
- 数字生命卡兹克:一文带你看懂 Skills,2026-01-22。
- eigent-ai/eigent 同期提交,2026-01-23。