2024 年 11 月 27 日 · Redis 深度实践 05
六个 Redis 进程都启动了,cluster_state 也是 ok,应用却连不上。再看节点公布的地址,是容器内部 IP。换一套部署,应用能连上种子节点,却在 MOVED 之后超时,因为目标节点的端口没有放通。
集群问题常常卡在这些边界上:客户端到底能访问哪些地址,数据怎么路由,主节点退出后谁能投票,应用会不会把重试变成重复扣减。
我会从“为什么要分片”开始,再搭一套 Redis 7.2.6 的三主三从实验。创建集群只是中间一步,最后得让业务读写和故障恢复也通过验收。
先确认需要的是容量分片,还是自动切换
| 方案 | 解决的主要问题 | 需要面对的限制 |
|---|---|---|
| 单主加副本 | 数据副本、部分读流量扩展 | 主节点的写容量和数据容量仍受单节点限制 |
| Sentinel 管理主从 | 监控、发现、主节点故障切换 | 数据集仍在一个主节点上,客户端要支持发现 |
| Redis Cluster | 按槽分片,并结合副本进行故障切换 | 多 Key 同槽约束、重定向、扩容迁移与更多运维复杂度 |
副本承担读流量时,还要接受复制延迟,不能默认获得写后立即可读。Sentinel 和 Cluster 也不是“谁更高级”的关系;单实例容量够,主要需求是自动切换,Sentinel 就值得认真评估。Sentinel 文档
如果决定用 Cluster,就要让应用端也进入设计。它不是在单机前面加一个透明负载均衡器。官方扩容与集群教程
16,384 个槽,才是数据路由的基本单位
默认情况下,一个 Key 的槽位按下面的方式确定:
1 | slot = CRC16(key) mod 16384 |
存在有效的 hash tag 时,参与计算的是第一对符合规则的大括号里的非空内容。例如 order:{42}:meta 和 order:{42}:items 都按 42 计算,落在同一槽。集群规范中的 hash tag 规则
这次实验得到:
| Key | 槽位 |
|---|---|
| order:{42}:meta | 8000 |
| order:{42}:items | 8000 |
| order:42:meta | 9777 |
| order:42:items | 9919 |
多数需要操作多个 Key 的命令、事务和脚本,都要面对同槽要求。对最后两个 Key 直接执行 MSET,实验收到 CROSSSLOT Keys in request don't hash to the same slot。
hash tag 应该围绕需要原子操作的业务单元设计。把所有 Key 都写成 {global}:... 虽然容易同槽,却把写入和内存集中到一个分片上,整个集群的扩展收益就被自己吃掉了。一个超大租户全进同一槽,也要评估热点和单分片容量。
三主三从,还要落到真实的故障域
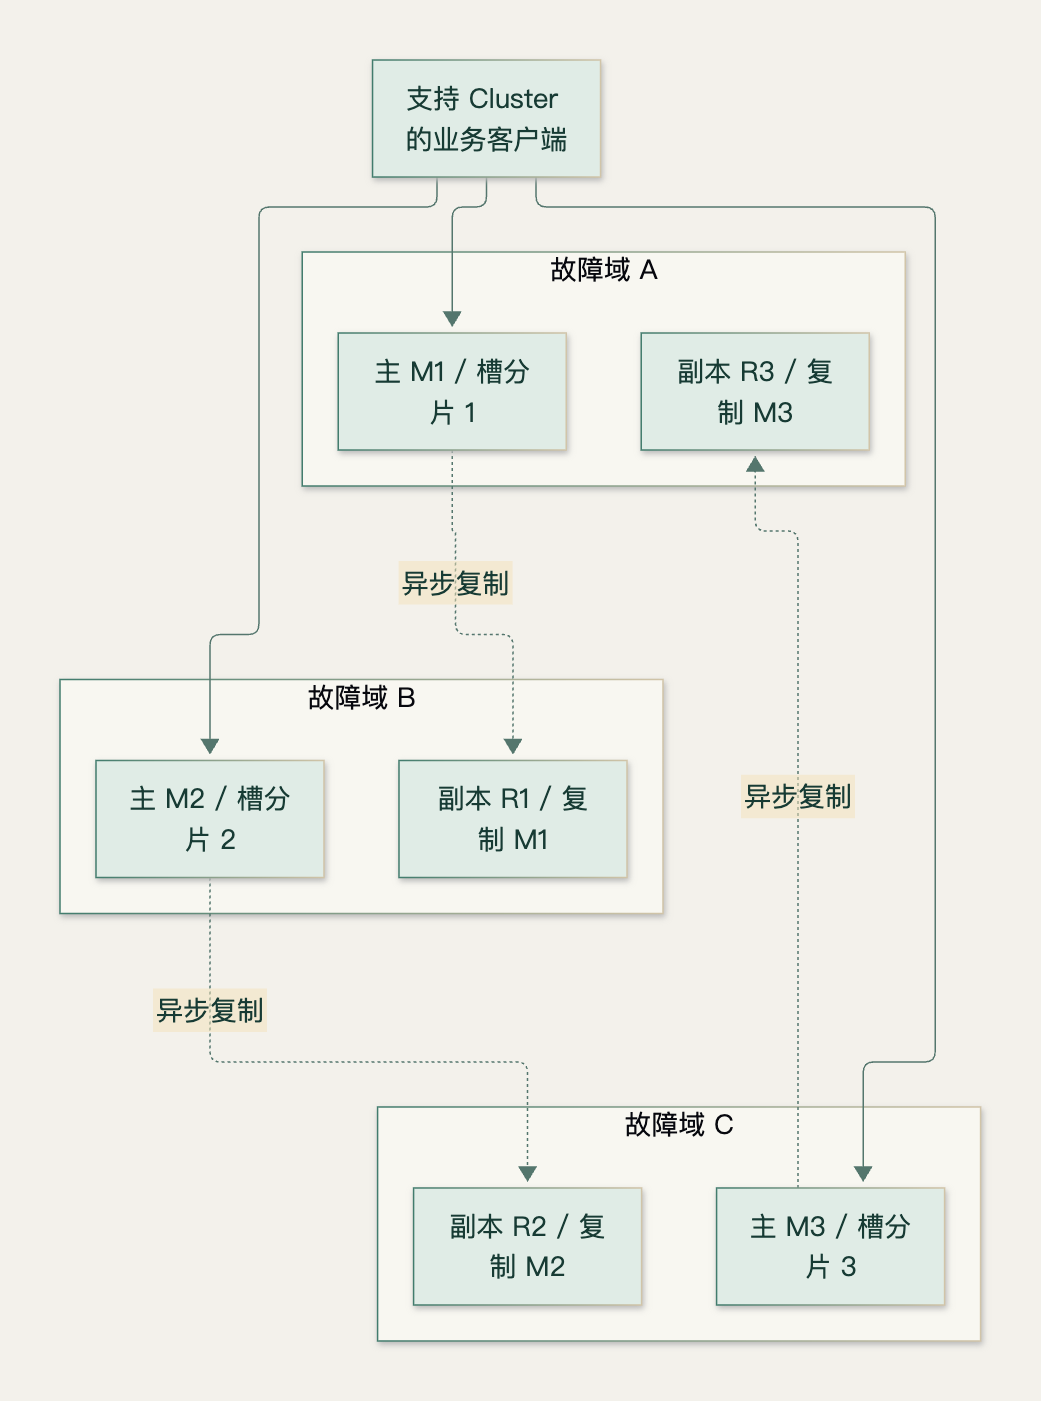
图里的三个主节点分别在三个故障域,副本交叉放置,避免主从一起被一台主机或一个故障域带走。单故障域退出后,仍要让足够的主节点可达,并让丢失主节点对应的副本有机会晋升。
三主三从只是常见起点。能容忍哪些故障,要结合投票、分片副本存活情况和网络分区来算,不能简单说“六台能坏三台”。如果一个分片的主从都没了,其他分片再健康也无法补出它的数据。
本地六进程实验只能验证协议、路由与进程故障切换。六个容器即使看起来隔离,只要还在同一主机,也共享电源、内核、磁盘和网络故障域。
配置先保证地址可达,再考虑调参
一个普通 TCP 节点至少涉及客户端端口和集群总线端口。默认总线端口通常是客户端端口加 10,000,也可以显式指定。客户端还需要访问重定向可能指向的每一个节点;节点之间需要总线通信和复制连接。
下面是某个内网节点的配置骨架,IP、内存和目录只是示例,不能直接复制到别的主机:
1 | bind 10.0.1.11 |
这个片段只展示网络、集群和存储骨架。生产还需要在建群前配置 ACL、复制认证、必要的 TLS 和网络访问边界;protected-mode yes 不能替代这些设置。noeviction 也意味着应用必须正确处理内存满时的写入错误。7.2.6 配置注释、安全说明
nodes.conf 是 Redis 自己维护的集群元数据,每个节点独立保存并持久化。不要把六份文件做成同一份配置模板,更不要在节点重启时让它丢失。改应用配置和改集群拓扑,是两种不同的操作。
如果运行在容器或 NAT 后面,必须从真实客户端和其他节点分别验证 announce 地址。只在容器内部 ping 通,并不能说明外部 Cluster 客户端可用。本文实际实验采用本机原生进程,没有把未验证的容器网络方案包装成实测方案。
建群之后,我至少做四类验收
本地实验会创建六个干净目录,分别监听 18379—18384;总线端口为 28379—28384。每个目录都有自己的配置和 nodes.conf,节点只绑定 127.0.0.1。
核心建群命令如下,实际由脚本调用:
1 | "$REDIS_LAB_CLI" --cluster create \ |
--cluster-yes 适用于这套已知是全新目录的自动实验。生产建群前,要先核对目标地址、数据为空和主从分配,不能盲目套用自动确认。
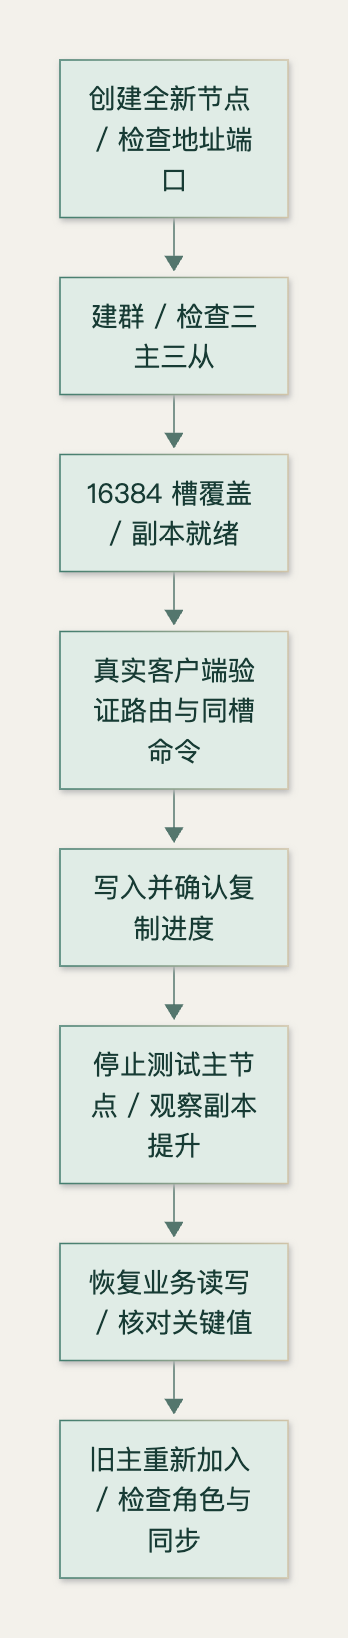
第一类是槽位和成员:三个主节点、三个副本、16,384 槽完整覆盖,复制关系符合预期。cluster_state=ok 还不代表所有副本已经追赶完成;实验会继续等待副本出现在槽位信息里,并检查复制连通状态。
第二类是路由:故意把 GET 发到不负责该 Key 的节点,观察 MOVED,再让支持 Cluster 的客户端完成正常读写。
第三类是命令兼容:同槽 MSET 能执行,跨槽 MSET 需要按预期拒绝;应用脚本、事务、批量查询和多 Key 删除都要逐一过一遍。某些客户端会把跨槽操作拆成多个请求,这会改变原子性和失败时的部分成功语义。
第四类是恢复:停止主节点,观察它的副本提升,验证关键值,然后让旧主重新加入,检查它是否转为副本并完成同步。
如果要边看边操作,可以启动配套的cluster_playground.py(代码见文末)。它保持运行直到 Ctrl-C,另开终端执行以下命令:
1 | python3 lab/cluster_playground.py --redis-server "$REDIS_LAB_SERVER" |
MOVED 和 ASK,客户端要做的动作不一样
MOVED 表示这个槽的路由应该更新,客户端通常会刷新槽位映射。槽迁移期间的 ASK 是一次临时转向,客户端要在目标节点先发送 ASKING,再发送原请求;它不等于永久更改该槽的归属。重定向规范
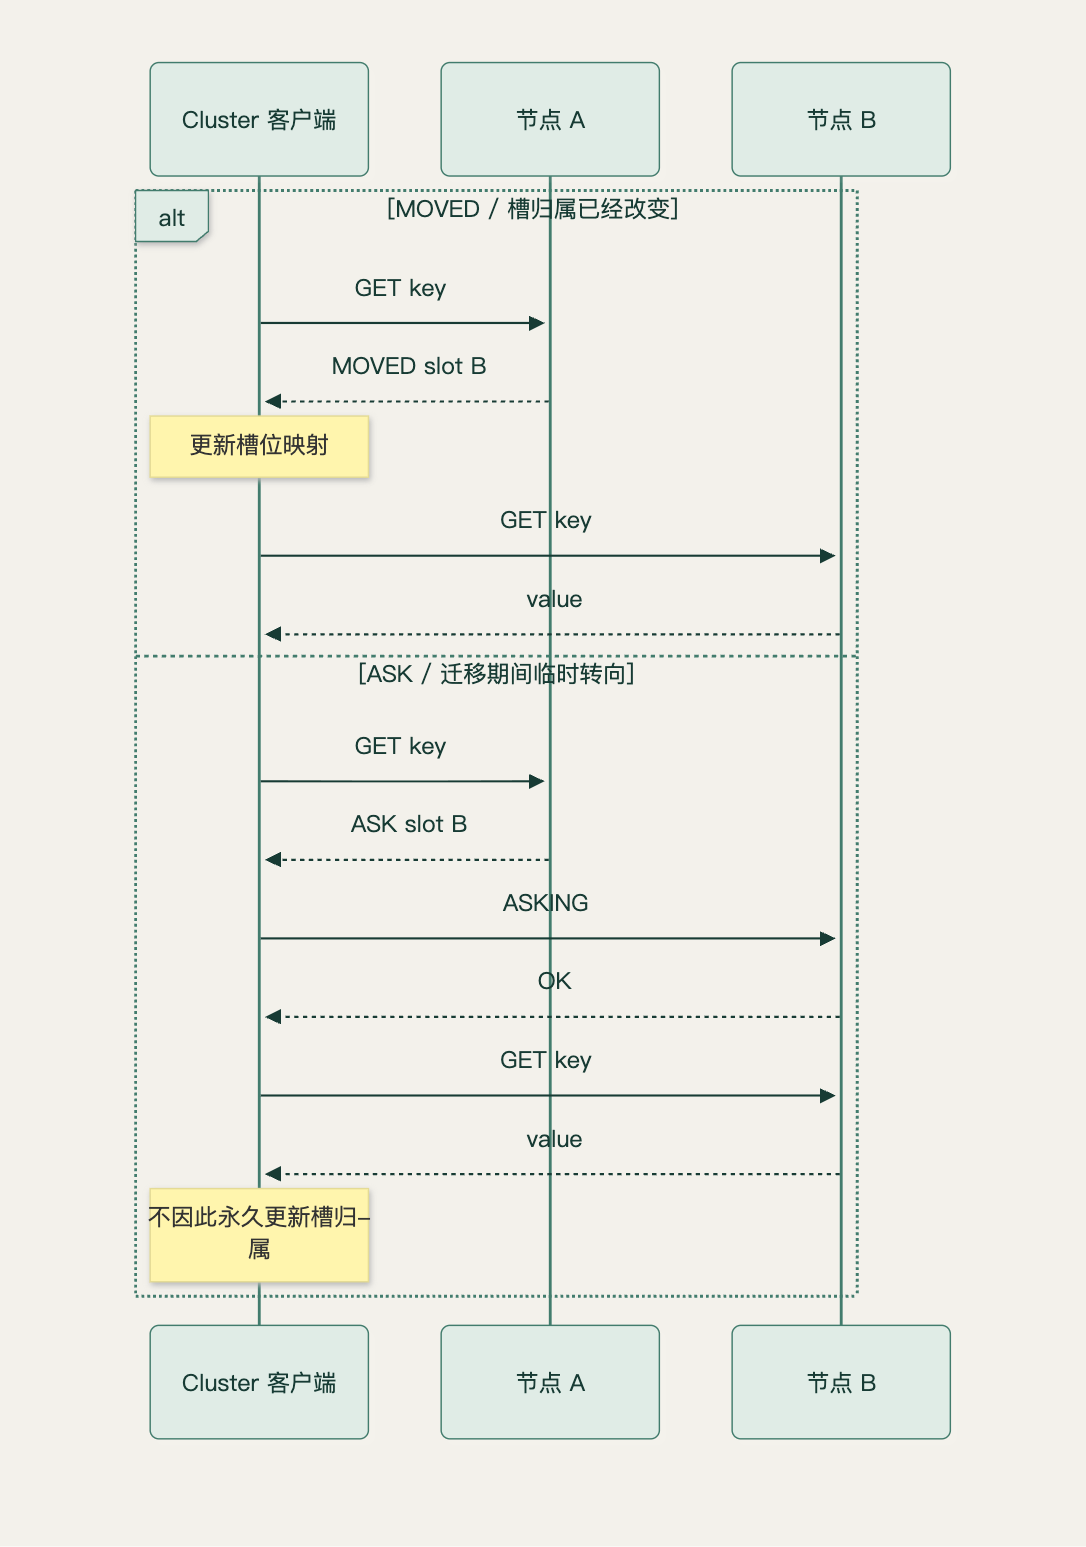
redis-cli -c 能帮命令行演示跟随重定向,业务客户端仍然需要选择支持 Cluster 的实现,并测试所用版本的行为。启动时配置多个可达种子地址,设置连接、命令和重试预算,避免只依赖一个入口。
客户端收到超时,也不代表写入没有发生。INCR、库存扣减等命令遇到重试时,要用业务请求 ID 或权威存储的幂等约束控制结果。只把重试次数调高,可能让短故障变成重复执行。
停一个主节点,结果要从业务读写里确认
完整故障实验执行方式:
1 | python3 lab/redis_lab.py cluster --redis-server "$REDIS_LAB_SERVER" |
脚本先找到测试 Key 所属的分片,写入后在同一连接上 WAIT 至少一个副本确认,再用 SIGKILL 停掉对应主进程,轮询副本角色和集群状态,最后读取原来的值。
| 检查项 | 本次观察 |
|---|---|
| 槽位与副本 | 16384 槽,3 主 3 从 |
| 停止的主节点端口 | 18380 |
| 提升的副本端口 | 18384 |
| 写入前后的确认 | 停主前 WAIT 返回 1;切换后读到 kept |
| 从停止进程到副本可读的观察时间 | 约 4.3 秒 |
| 旧主重新加入后的角色 | 副本(ROLE 返回 slave) |
这个结果证明了本次已确认写入在这次进程故障中被保留。它没有模拟未复制写入、网络分区、磁盘丢失或多个故障域退出。实验使用的 cluster-node-timeout=2000 也只是本地参数;故障发现、选举等待、复制状态和客户端恢复都会影响最终时间,不能把配置的两秒直接当成恢复 SLA。
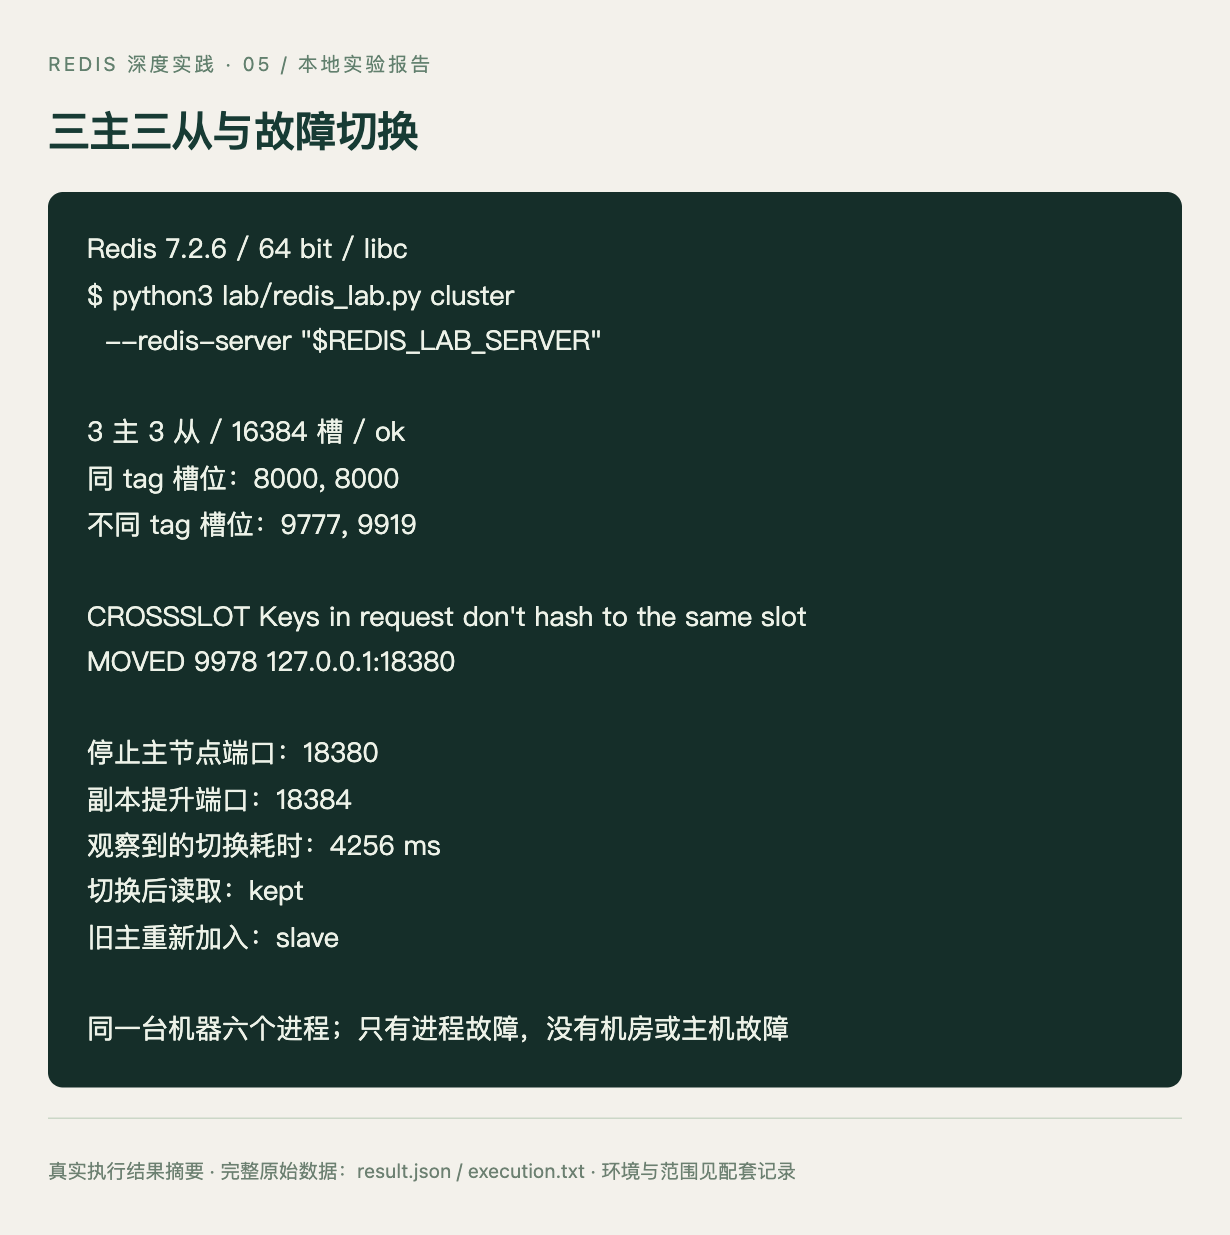
原始结果文件(见文末实验记录)和建群输出(见文末实验记录)都保留了。实验结束会关闭自己启动的进程;需要继续查看时,用前面的交互脚本。
扩容迁的是槽,不会自动拆开一个热点 Key
新节点加入后,不会凭空获得一部分数据。需要把槽迁给它,客户端也要处理迁移中的路由变化。容量规划还要留出迁移、复制和后台持久化同时发生时的内存与网络余量。
我会先迁少量槽,观察业务 P99、超时、复制延迟、迁移耗时和新旧节点负载,再继续。redis-cli --cluster reshard、rebalance 等命令涉及真实数据移动,应在确认目标、范围与备份后执行;本文只在文档层解释,没有声称完成生产扩容实测。官方扩容教程
大 Key 会让单次迁移更重。热点 Key 即使换了节点,仍然只由一个分片服务;单纯再加两个主节点不一定缓解它。可以根据一致性要求考虑应用本地缓存、读副本、业务拆分或聚合层限流,每一种都会改变读写语义。
集群里扫描数据也要改变做法。一次 SCAN 只遍历当前节点的数据,要覆盖所有主分片并去重;迁移期间的全局快照语义更不能想当然。全量删除、备份、巡检脚本都应该按集群实际拓扑执行。
一份可以交接的集群说明,应该长什么样
我会留下节点与故障域清单、每个分片的主从关系、网络端口、客户端配置、容量上限和恢复步骤。上线前模拟单节点退出和客户端重连;多主或网络分区演练则另设范围与回退方案。
前面的验收流程图对应四个检查点:地址可达、建群验槽、客户端验证、故障演练。
集群的价值最终体现在应用能否用好分片,并在故障后按约定恢复。把每次重定向、每次重试和每个故障域都纳入验收,六个节点才算组成一套能交接的服务。
实验环境与完整代码
先准备 Redis 7.2.6。以下操作只创建本机实验目录,需要 C 编译器、make 和 Python 3;Redis 实例仅监听回环地址。
1 | mkdir -p /tmp/redis-deep-lab-build |
在自己的实验项目中创建 lab/ 目录,把下面的 Python 代码保存为 lab/redis_lab.py,然后回到该项目根目录运行文中的命令。默认从 18379 端口开始;检测到已有服务会停止。脚本只关闭自己启动的进程,原始输出保存在项目的 assets/ 目录中。
展开本篇完整实验代码(Python 3,无第三方包)
1 | from pathlib import Path |
需要保留六个节点供手动操作时,把下面文件保存为 lab/cluster_playground.py,与本篇的 redis_lab.py 放在一起。新终端需重新设置 REDIS_LAB_CLI;按 Ctrl-C 关闭本次实验节点。
展开交互集群脚本
1 | #!/usr/bin/env python3 |
展开本篇实验记录
1 | { |
参考资料
- Redis Cluster 规范历史快照:槽位、重定向、选举与数据安全边界。
- 官方扩容教程历史快照:建群、节点配置和槽迁移。
- 7.2.6 集群实现:核对本篇使用版本的行为。
- 黄健宏,《Redis 使用手册》中的集群主题:用来补充命令与应用场景;部署和故障行为以上述固定版本资料与实验为准。